


专题主题汇总跨篇方法汇总
RSI(自进化)方法汇总:七篇论文到底改了什么、怎么迭代
这七篇的「自我改进」其实是七种不同的东西——改 harness 源码(RRSI)、改 harness 的持久状态(Prime Agent)、改 探索策略代码(Dream-RSI)、把 harness 配置做成可组合/可演化的一等对象并接上模型共演化(HarnessX)、测量"模型能不能自己造并改 harness"这件事本身(HarnessDev)、把执行成…
PAPER READING NOTES
把一篇论文读成自己的东西:核心结论、方法拆解、关键数字与横向对比。
LIBRARY
按论文、博客与主题汇总浏览。搜索、筛选和排序都保留,只是换了一种更安静的读法。
这七篇的「自我改进」其实是七种不同的东西——改 harness 源码(RRSI)、改 harness 的持久状态(Prime Agent)、改 探索策略代码(Dream-RSI)、把 harness 配置做成可组合/可演化的一等对象并接上模型共演化(HarnessX)、测量"模型能不能自己造并改 harness"这件事本身(HarnessDev)、把执行成…
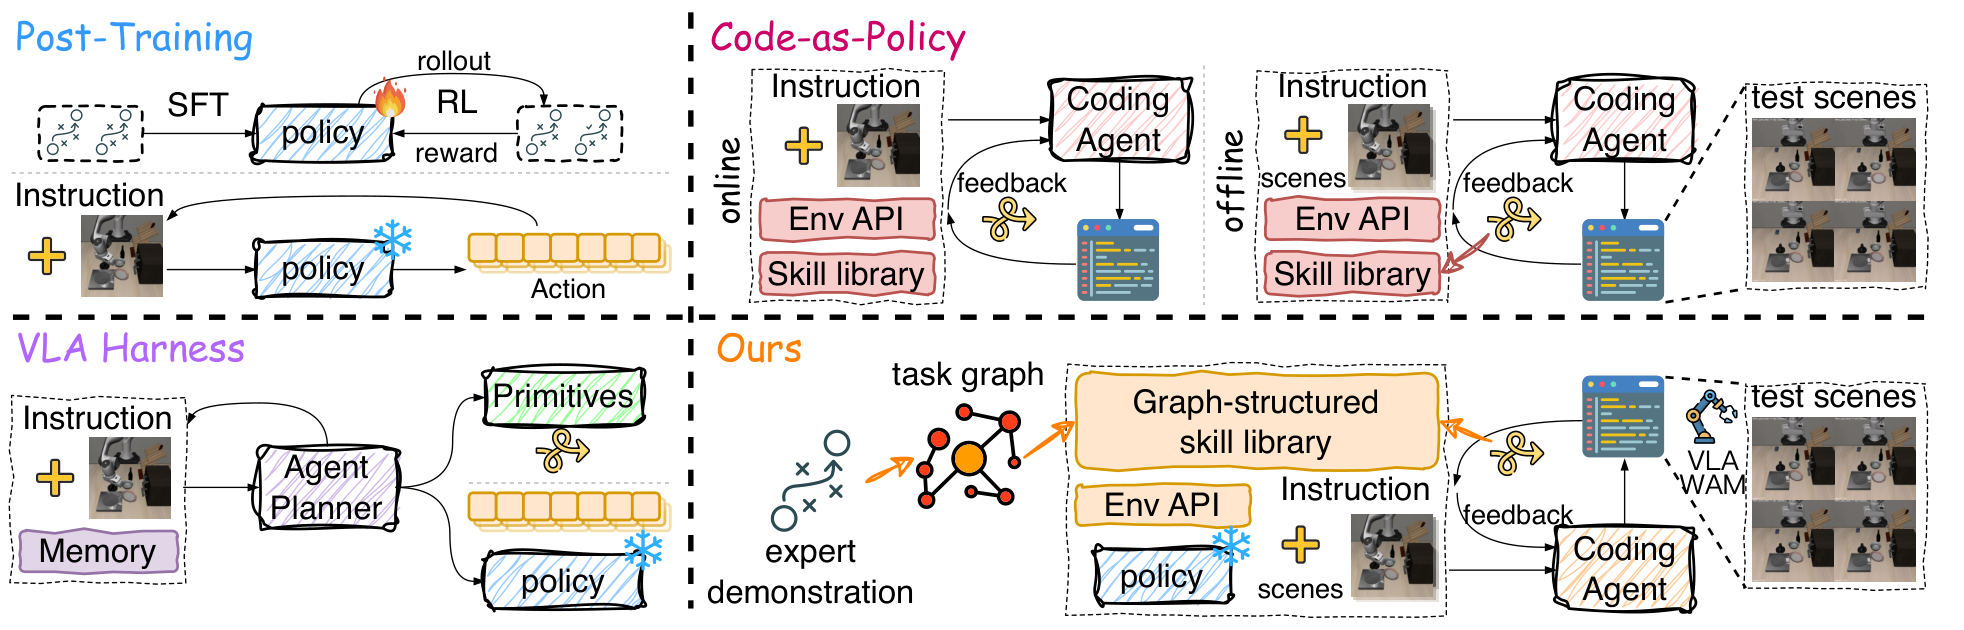
HarnessPAI: An Evolving Harness for Physical AI
HarnessPAI 不把 VLA/WAM 当成整个 agent,而把它降为「动作原语」;在单次 rollout 内运行一个固定的、带感知/几何推理/成功检查的可执行程序(open-loop),在多次 rollout 之间用执行反馈让 coding agent 修改程序、把失败蒸馏成按任务图节点索引的 repair skill(closed-loop)。
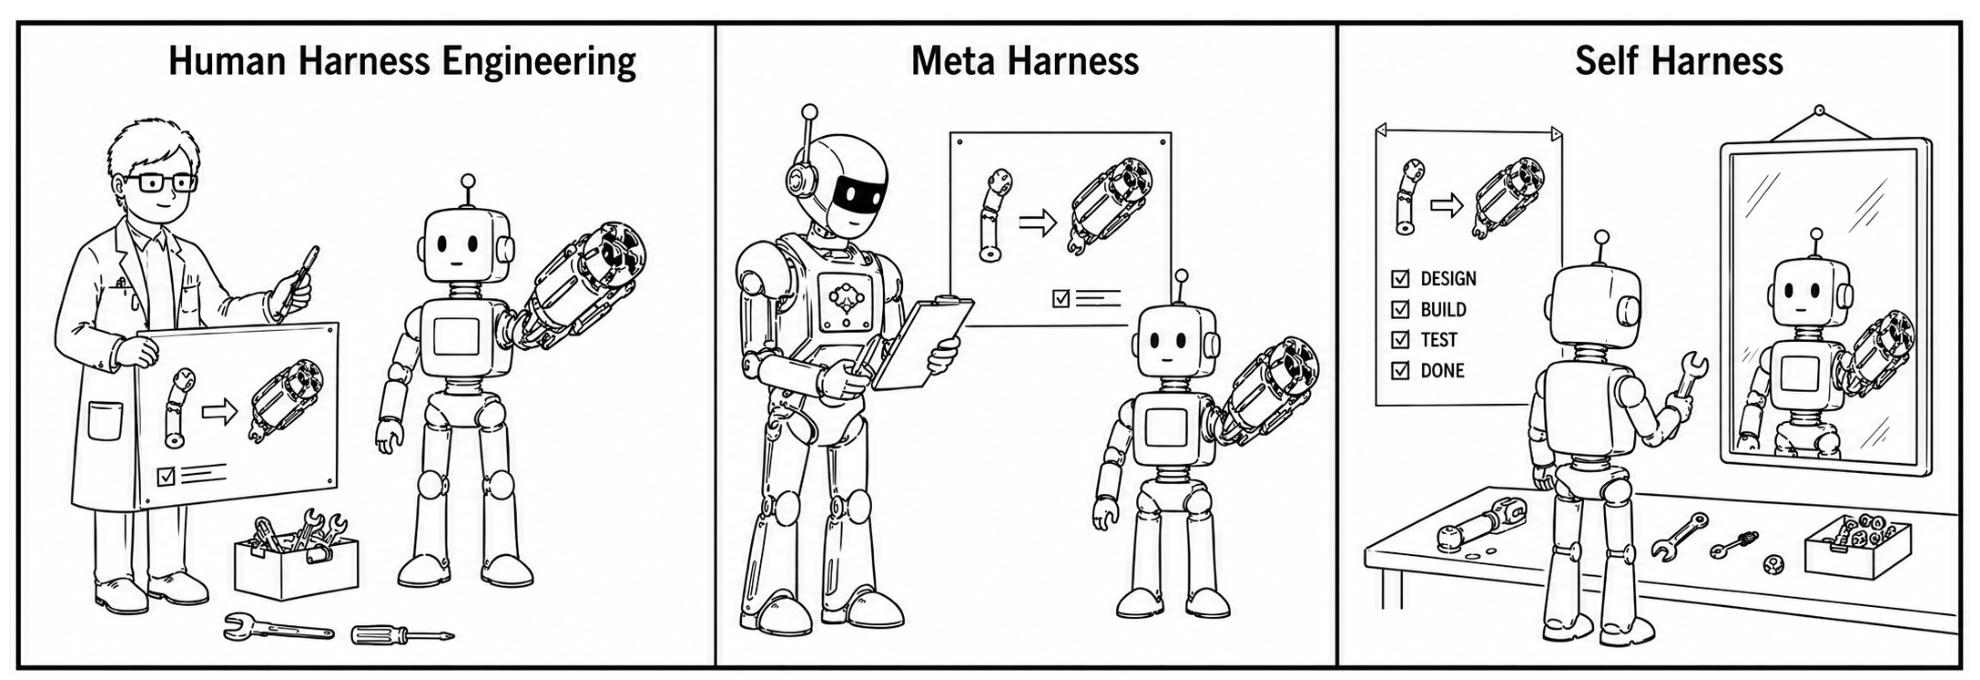
Self-Harness 让同一个固定模型扮演 proposer,从 verifier 归因后的失败簇出发,对自己 harness 的声明式配置做少量有界编辑;每个候选在 held-in 与 held-out 上做回归门控,只有两侧都不降且至少一侧升高的编辑才被合并。
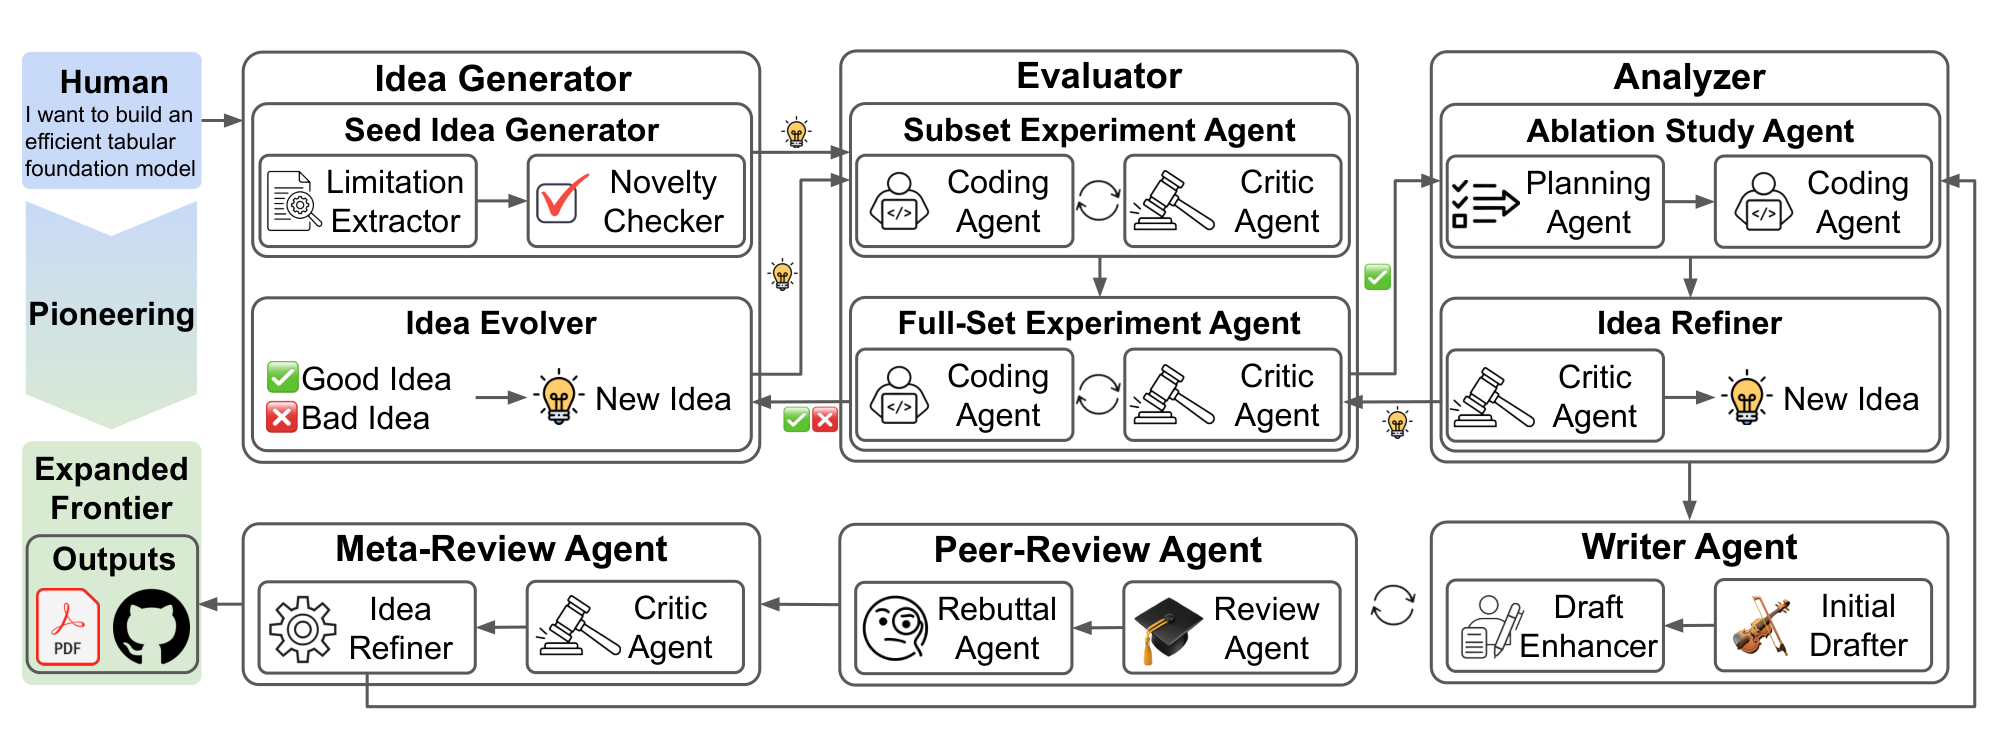
ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI
ScientistTwo 把科研流程拆成 6 组 agent + 一条带 critic 关卡的闭环:给定一篇人类论文的问题与代码库,它自己找局限、生成并进化想法、先在子集上筛、再放大到全集、做消融归因、写稿,最后用模拟评审 + rebuttal + meta-review 反复改到“可接受”为止。
The components of agent memory
Anthropic 把 agent 记忆拆成「可搜索的会话日志 → Claude 写的记忆笔记 → wiki 等结构化表示 → 每会话预加载的注入上下文」四层,并用一个离线计算过程(dreaming)在层与层之间搬运、纠错和整理;真正难的不是「记住更多」,而是判断什么值得记、以及如何让记下来的东西保持正确且足够小。
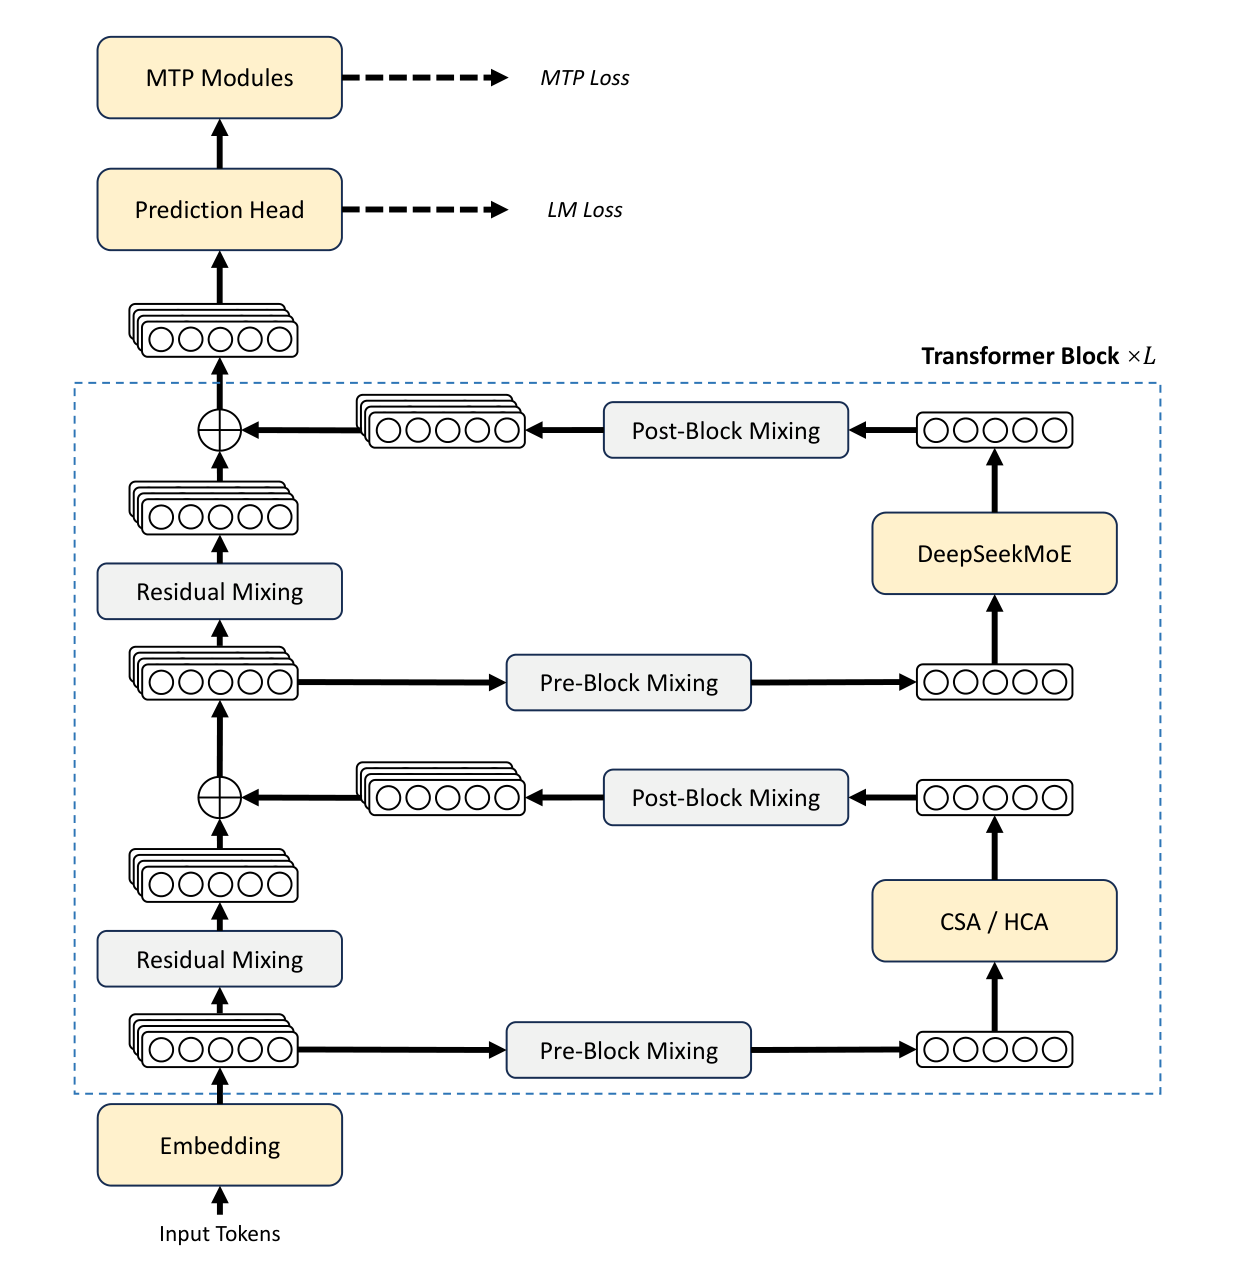
V4 不是「再堆一个更大的 MoE」,而是一次效率优先的重构——用 CSA(4:1 压缩 + top-k 稀疏)与 HCA(128:1 压缩 + 稠密注意力)交替替换 MLA,用 mHC 把残差映射约束到双随机矩阵流形上,用 Muon 替换大部分模块的 AdamW,把 1M 上下文的单 token FLOPs 压到 V3.2 的 27%、KV cache…
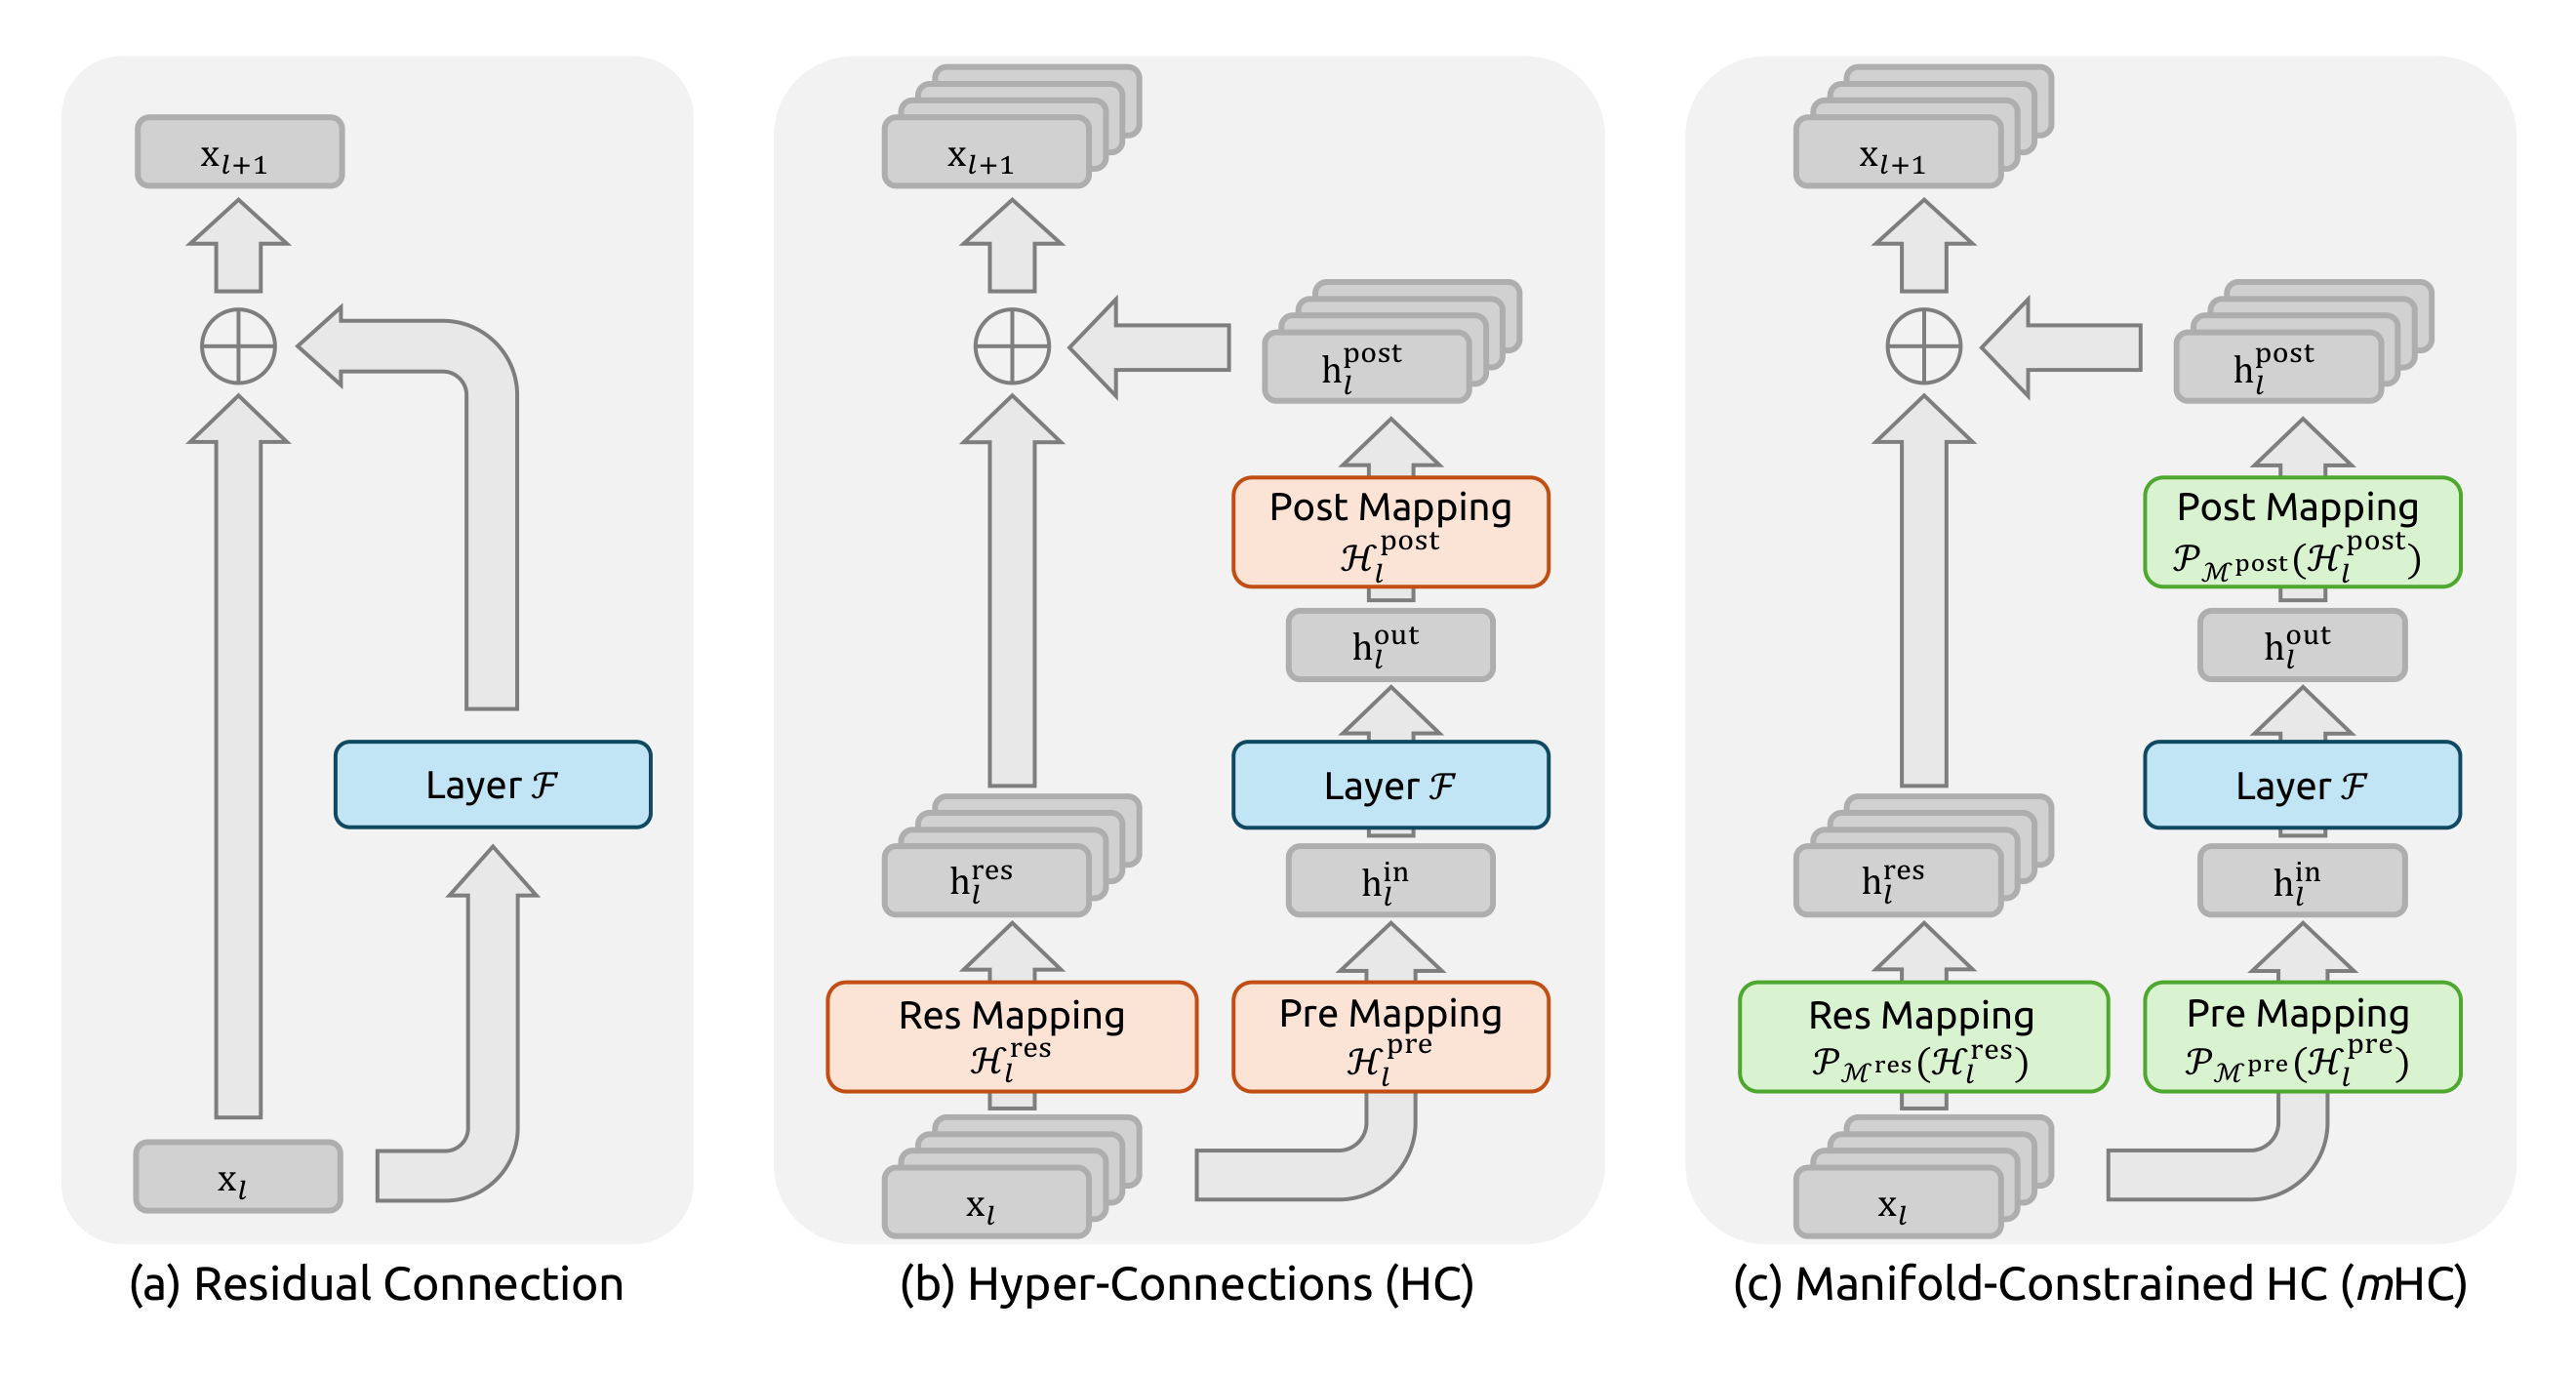
mHC 是 Hyper-Connections(HC)的约束版本:保留 HC「把残差流加宽到 n 倍、学习跨流混合」的拓扑收益,但把残差映射 H_res 投影到双随机矩阵(Birkhoff 多面体)上,使信号传播满足均值守恒与非扩张性,从而恢复深层训练的稳定性。配套的 kernel 融合、选择性重算与 DualPipe 重叠,把 n=4 时的额外训练时间压…
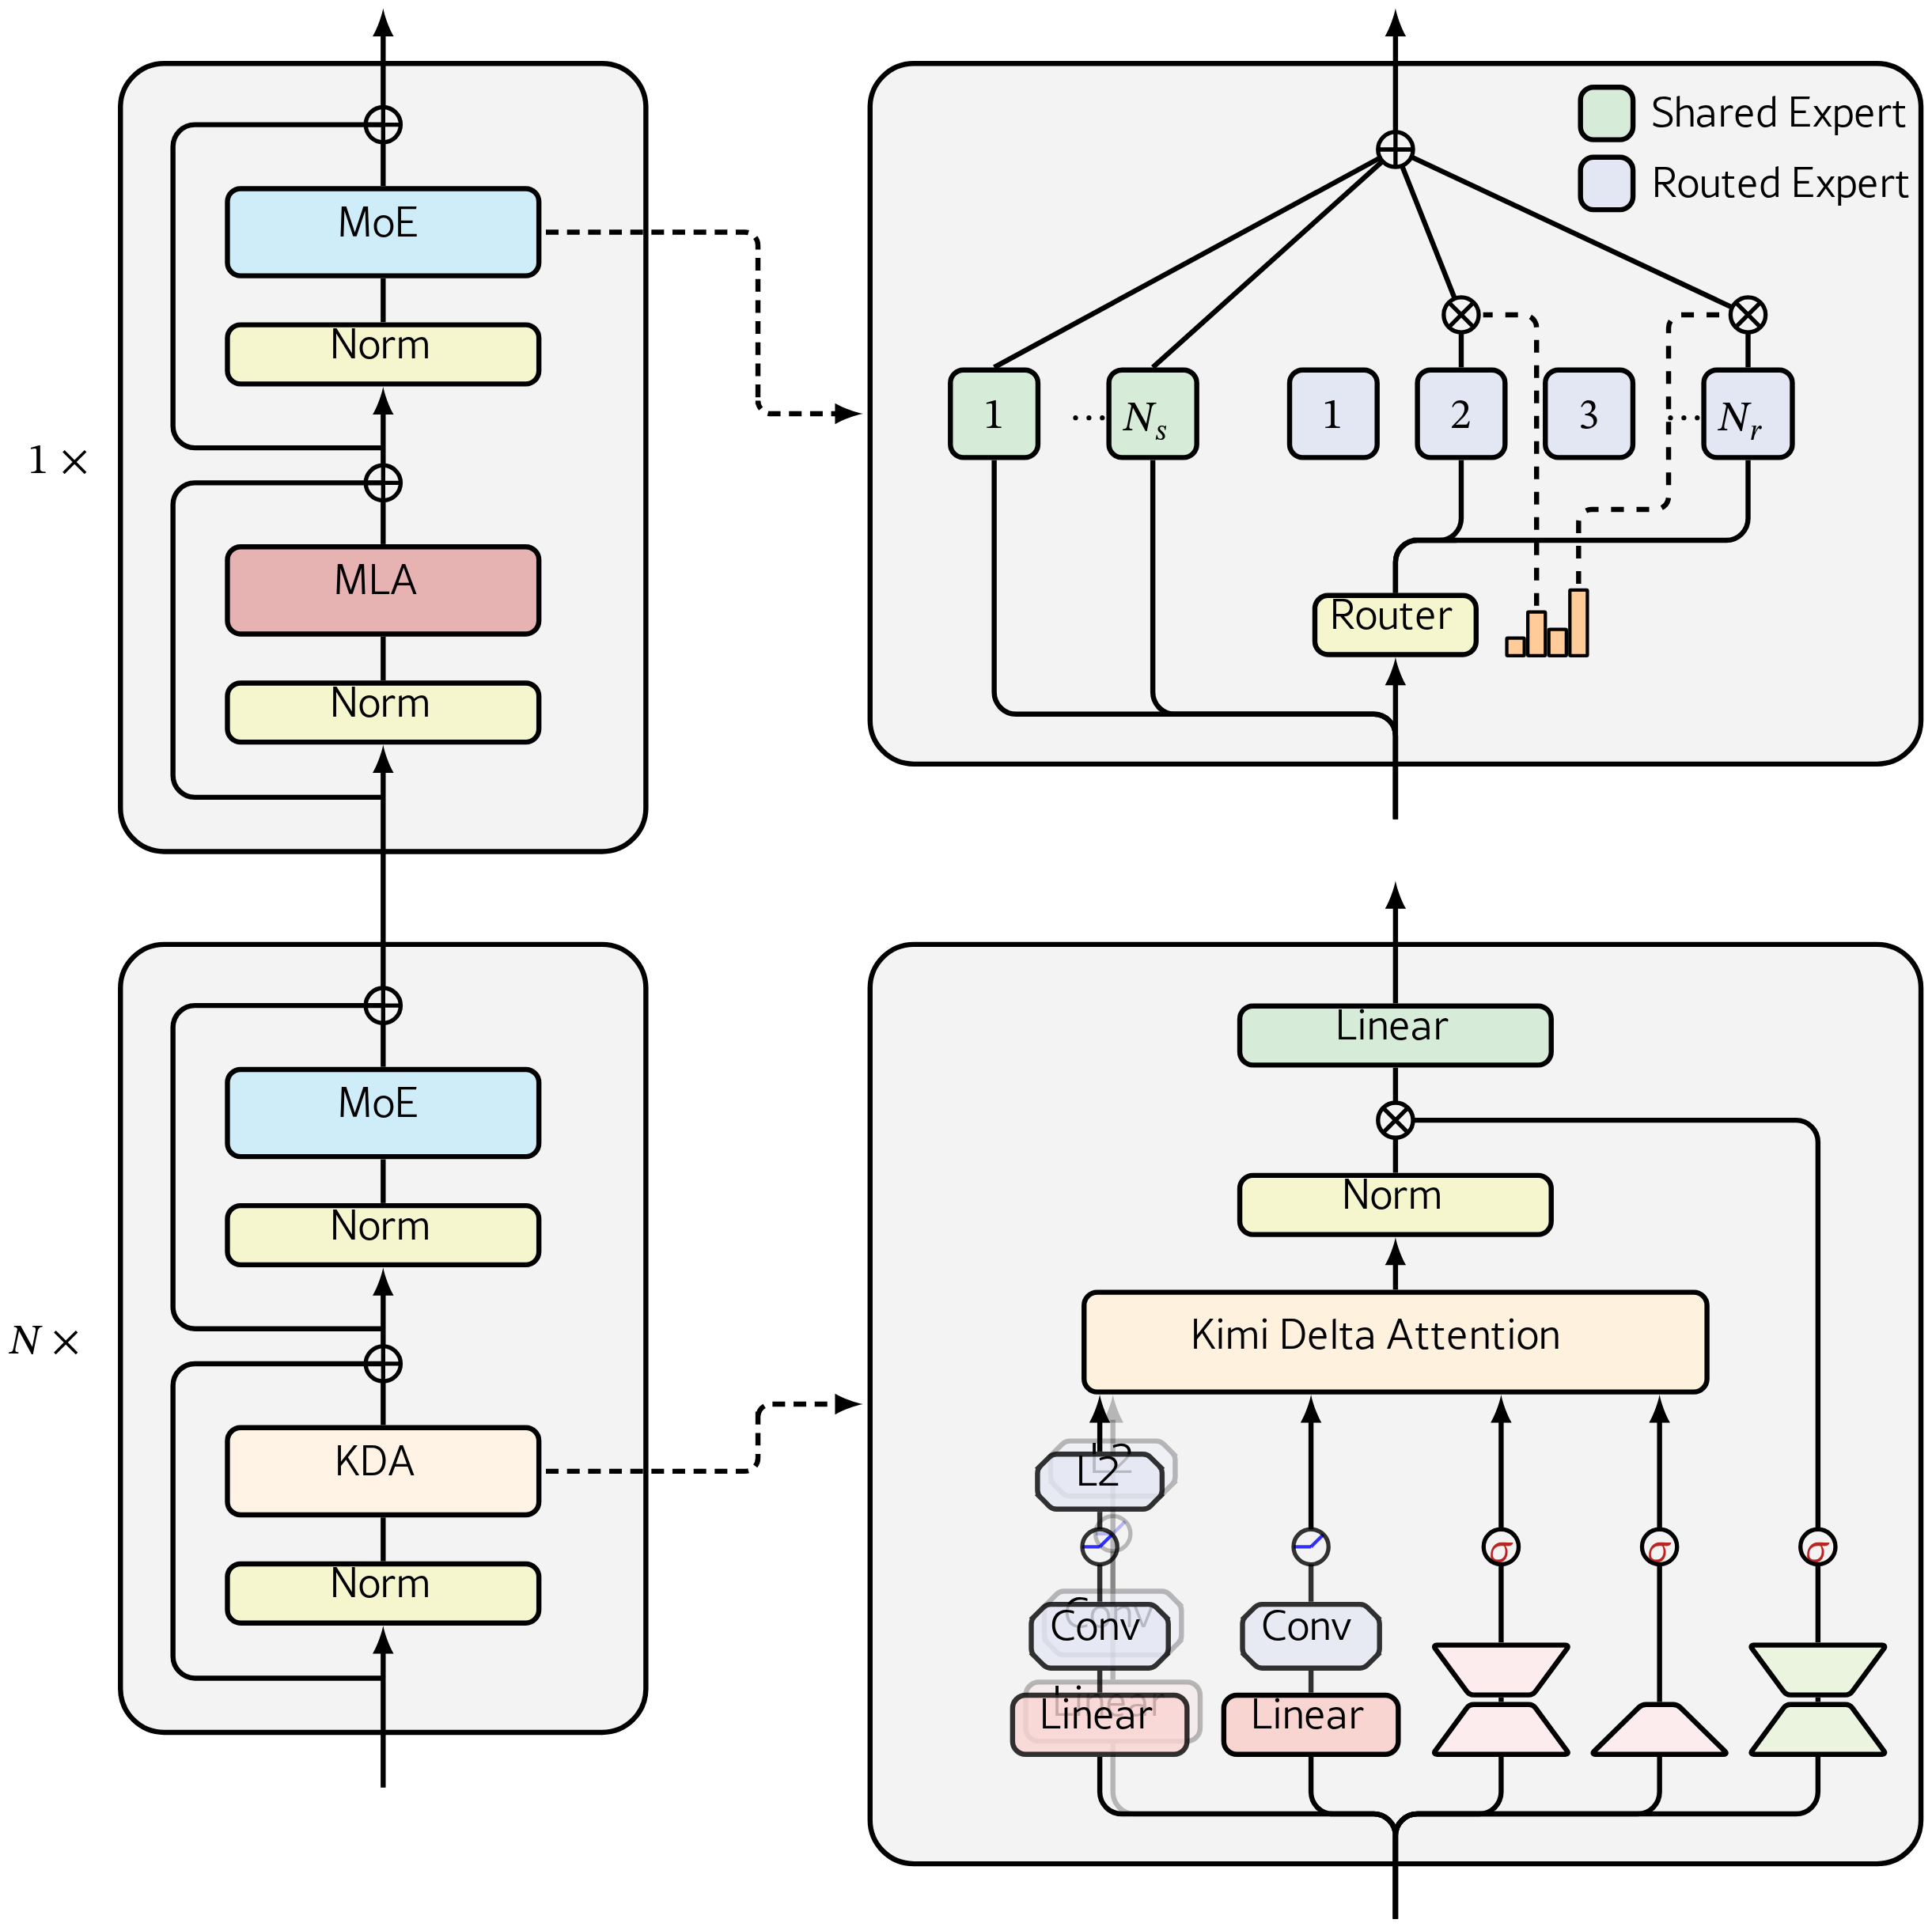
Kimi Linear 把 Gated DeltaNet 的标量遗忘门换成逐通道门(KDA),用受限 DPLR(把 a、b 都绑到 k 上)加 UT 变换把它做成可分块并行的核;再按 3:1 交错 KDA 与 NoPE 的 MLA,在同配方、同 1.4T token 的对照里多数基准超过全注意力基线(作者称「首次」),并把 1M 上下文相对 full-ML…
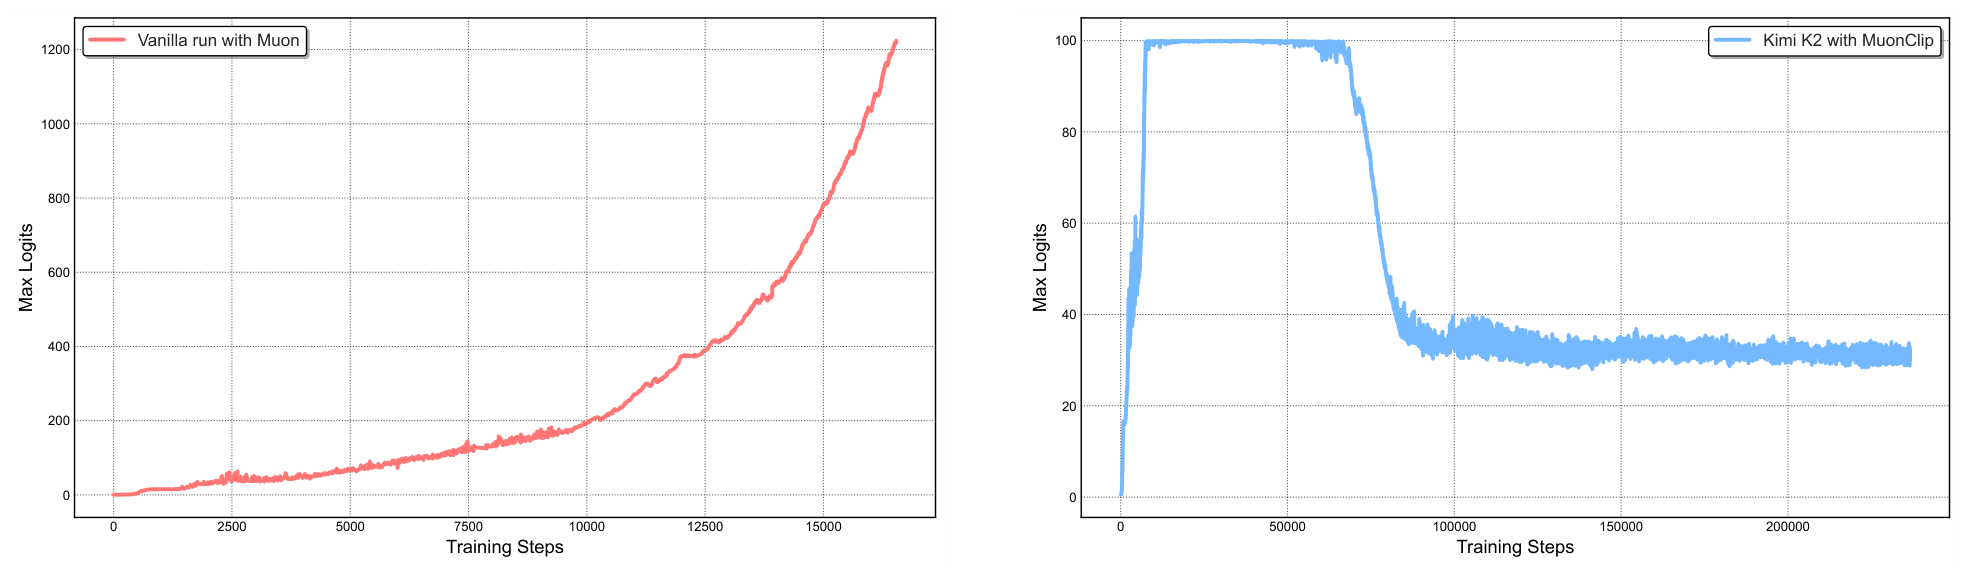
K2 把「超稀疏 MoE + MLA + 64 个注意力头」推到 1.04T 总参数 / 32.6B 激活,用 MuonClip(Muon + 逐头 QK-Clip)在 15.5T token 上做到零 loss spike;再用「大规模合成工具调用轨迹 + 可验证奖励与自我批评 rubric 的 RL」把非思考模式下的 agentic 能力推到开源模型前…
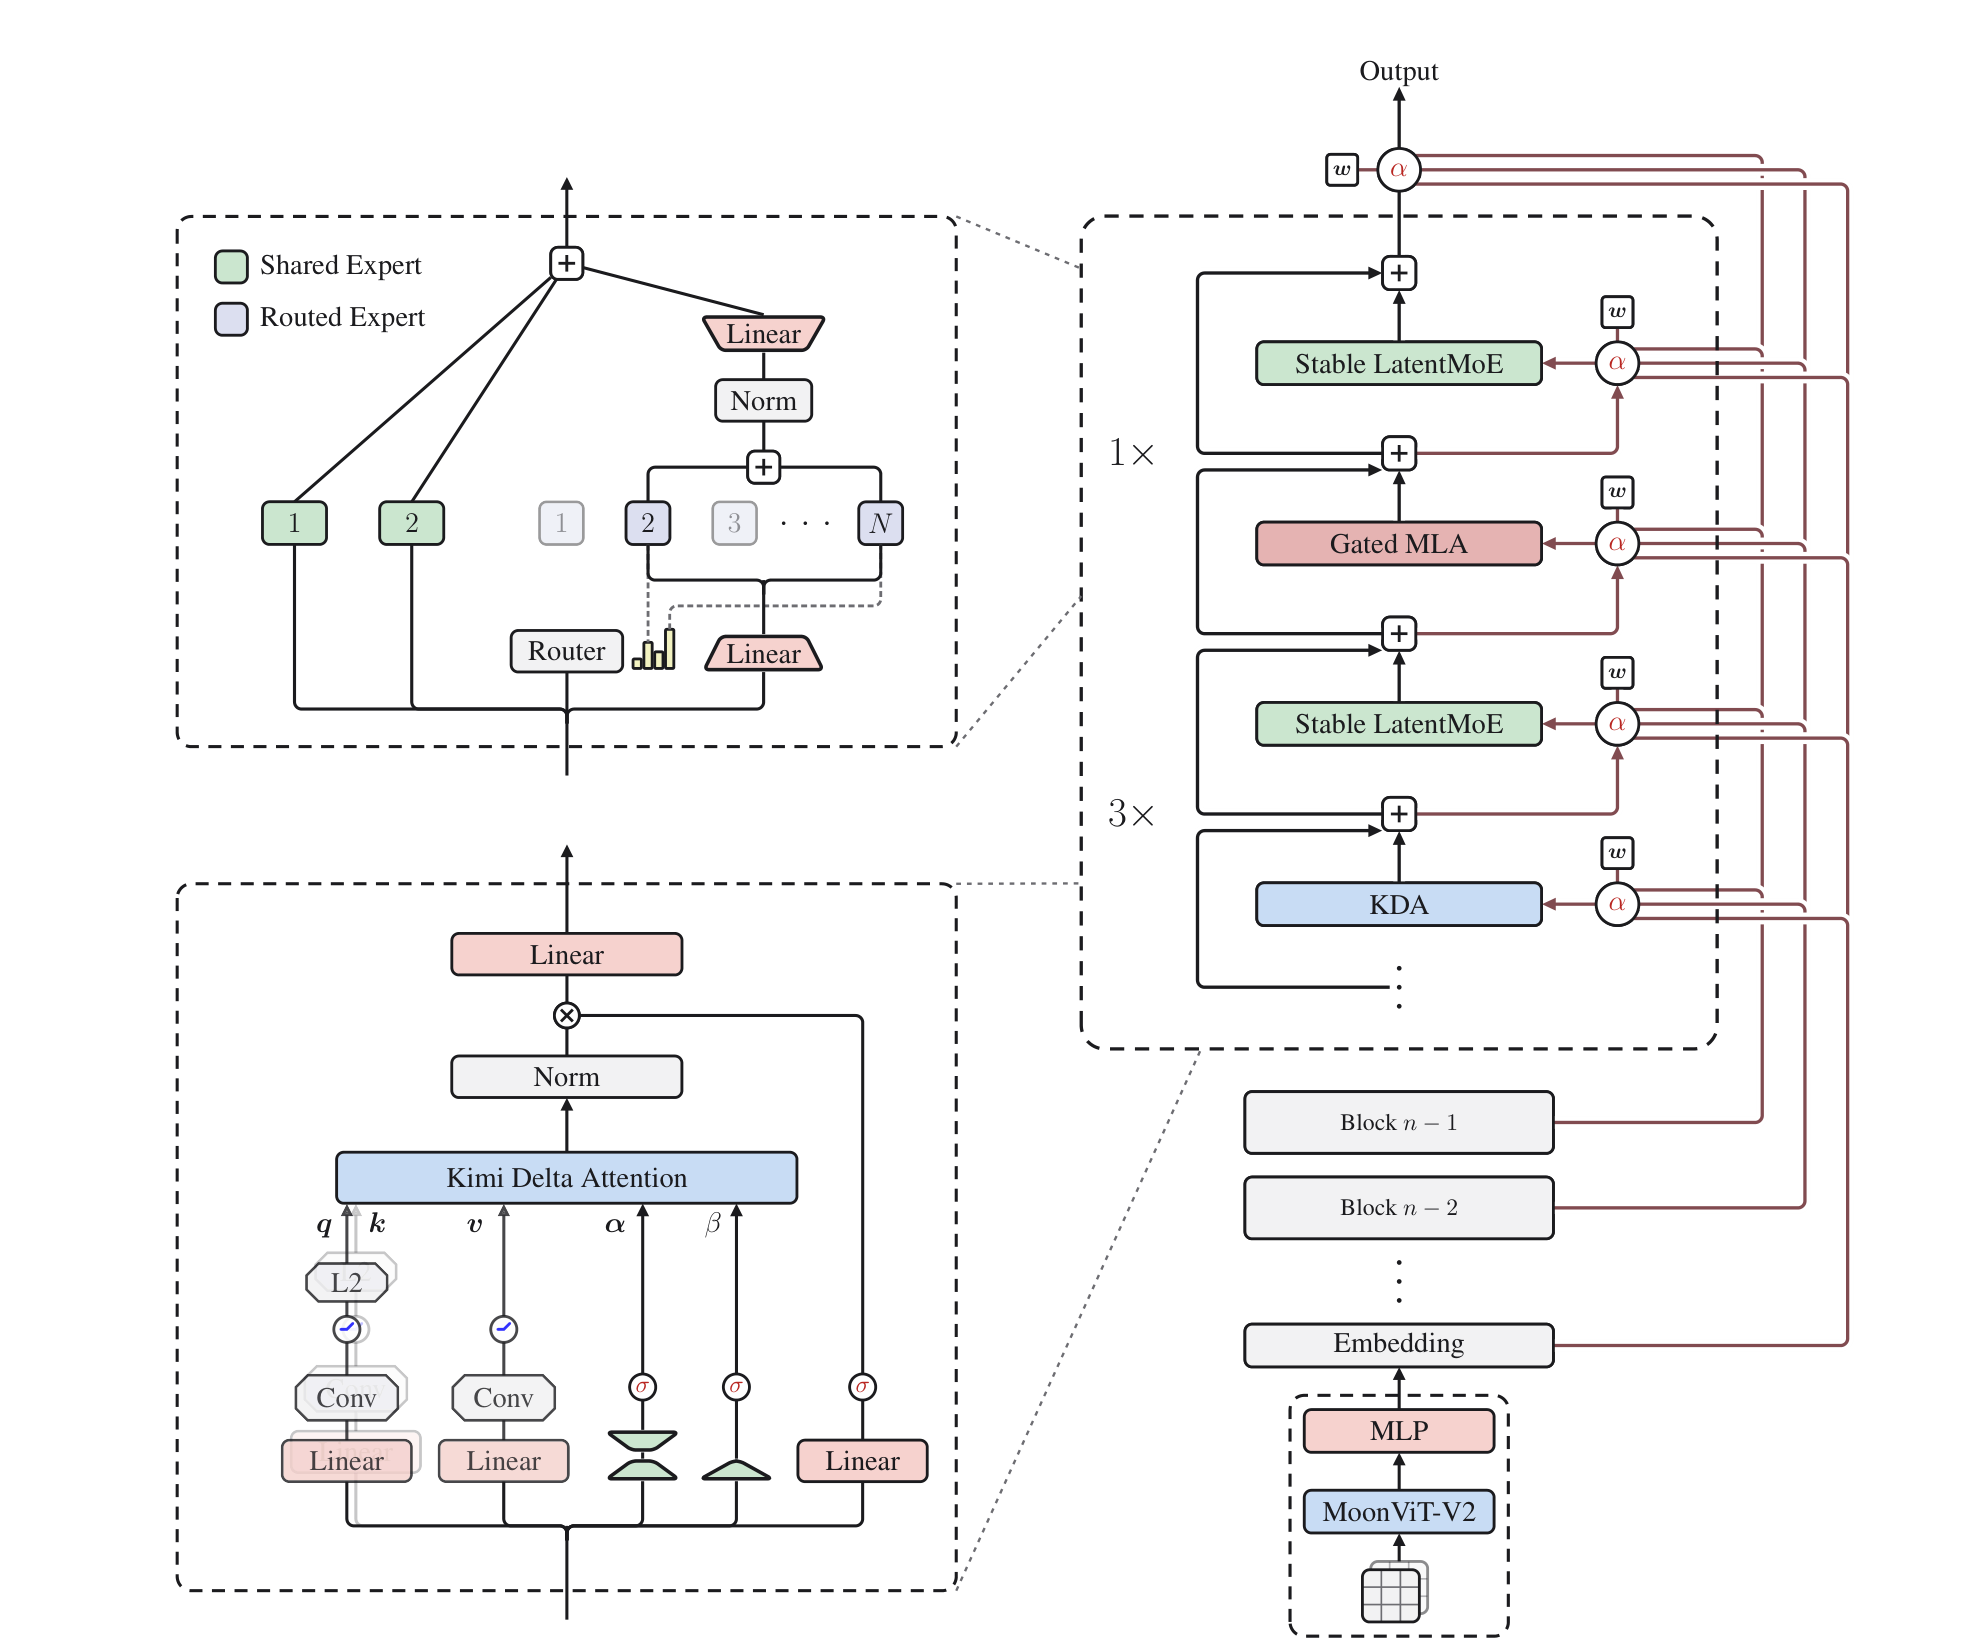
K3 把「开源模型的规模上限」从 1T 级推到 2.78T 总参数 / 104.2B 激活,并用三条不同方向的「信息流」改造(序列方向 KDA+MLA 混合注意力、深度方向 Attention Residuals、宽度方向 896 专家的 Stable LatentMoE),配合数据与训练配方换到约 2.5× 的 scaling 效率,再配上百万 toke…
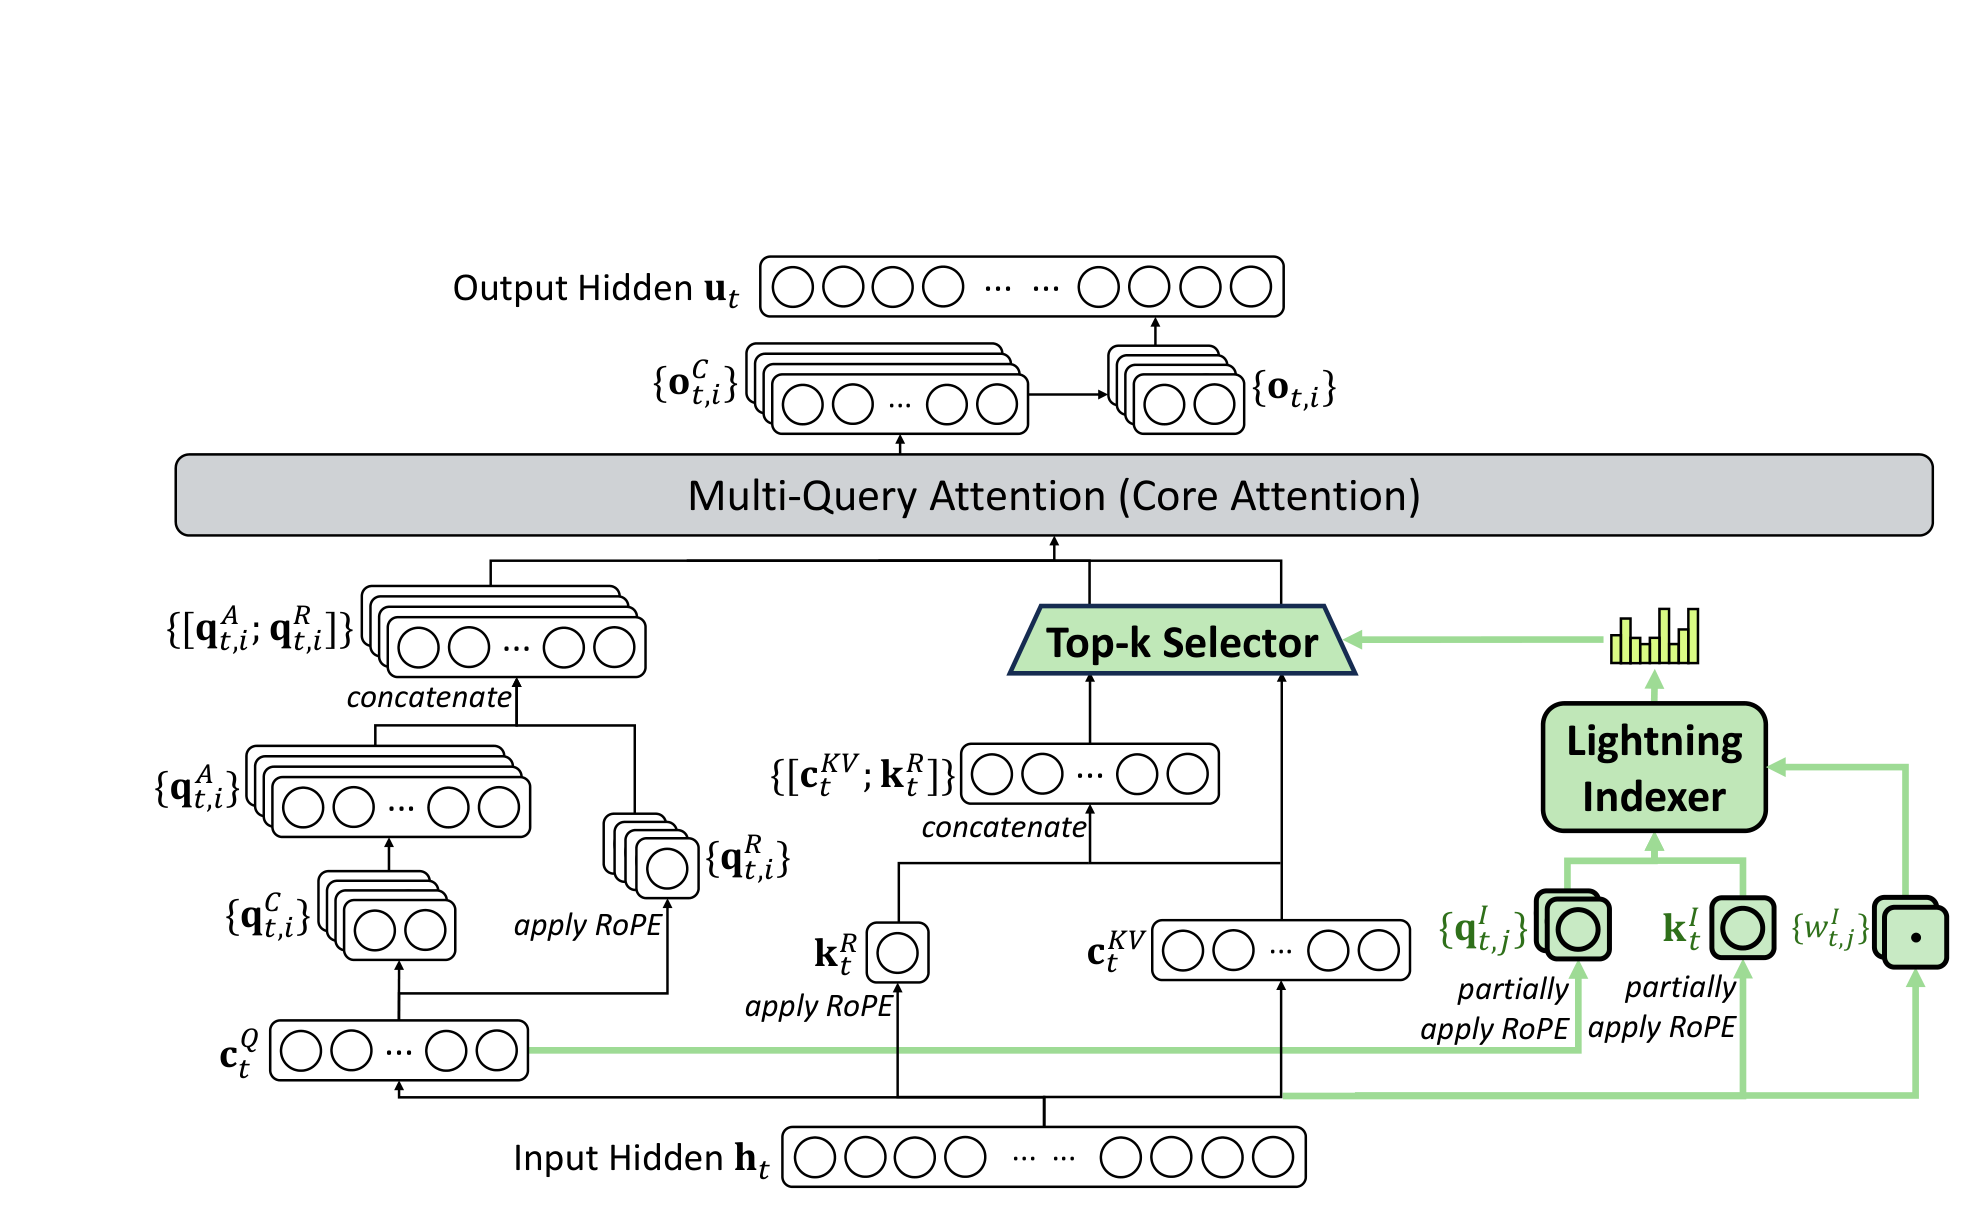
V3.2 不是重新预训练一个模型,而是在 V3.1-Terminus 上通过继续预训练植入 DSA(稀疏注意力),再用超过预训练成本 10% 的后训练算力、约 8.5 万条 agent 任务做 RL,把开源模型在 reasoning 上推到 GPT-5 附近、在 agentic 任务上明显拉近,同时把 128K 上下文的服务成本压到 V3.1-Termin…
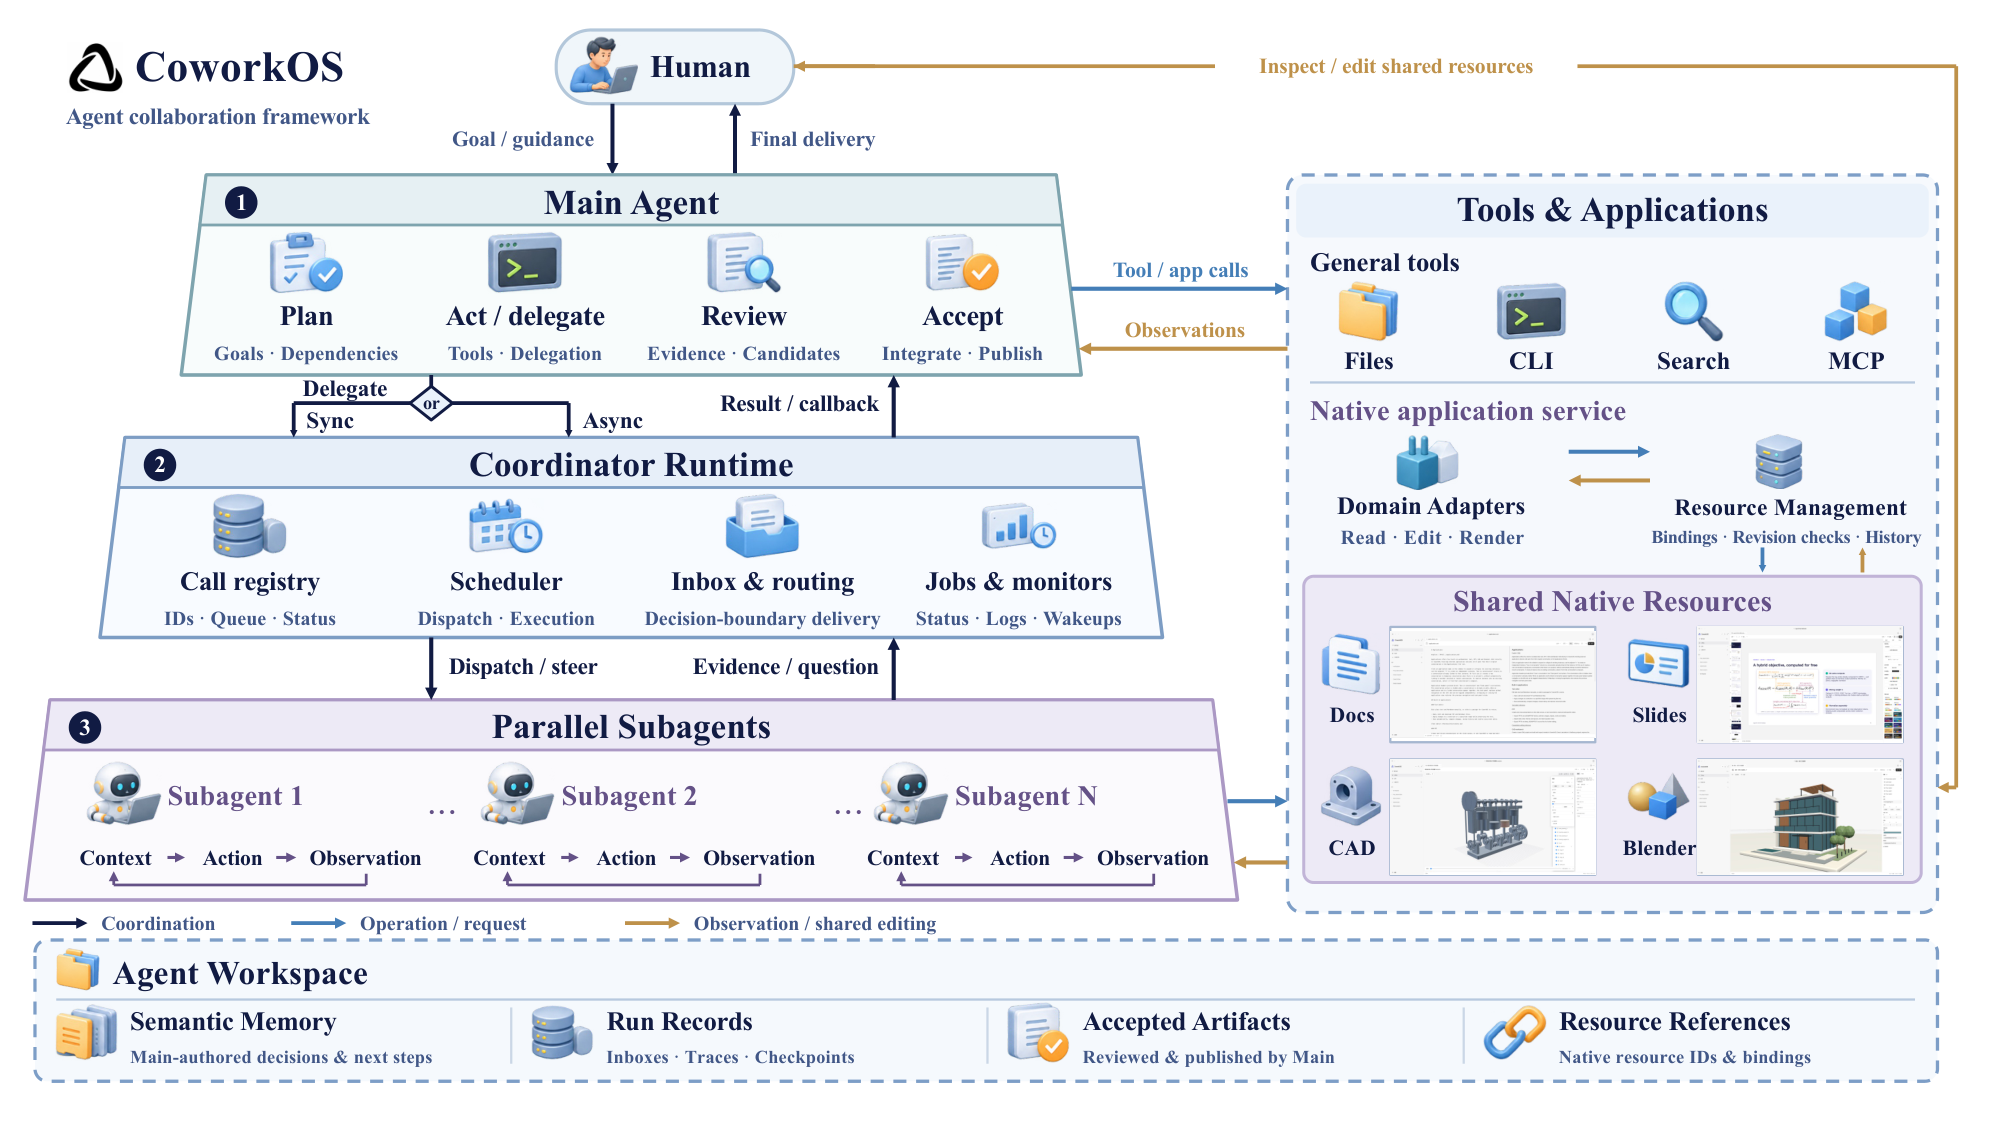
CoworkOS: Scaling Agent Coworkers for Real-world Automation
CoworkOS 不是一个模型,而是一层跑在模型和真实工作之间的 harness(运行时)。它的分工是:模型只负责决策(做什么、派给谁、接不接受结果),运行时负责保存状态、传递反馈、维持长周期执行。围绕这条分工,论文给出三块东西:
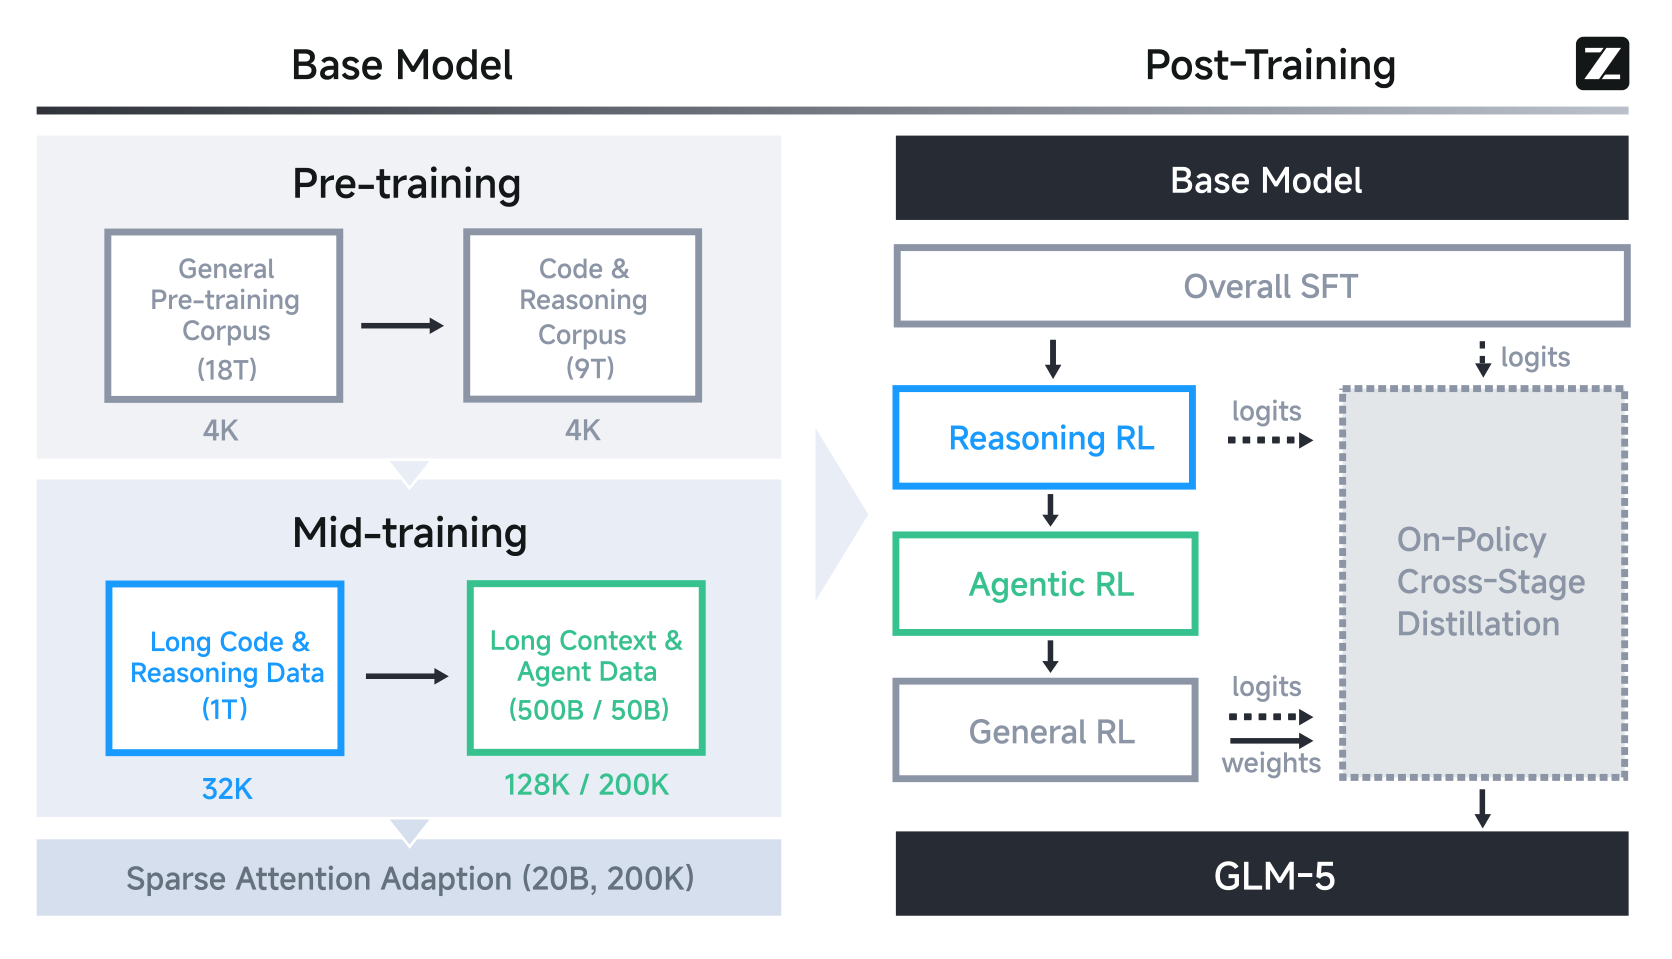
GLM-5: from Vibe Coding to Agentic Engineering
GLM-5 是 GLM-4.5 的「成本压缩 + 长时程工程化」版本——用 MLA+DeepSeek 稀疏注意力(DSA)把 744B(40B 激活)模型的长上下文训练/推理成本压下来,用全异步 RL 基础设施和环境规模化把 agent 训练推到长时程,再用跨阶段 on-policy 蒸馏把多段 RL 的能力回退补回来。
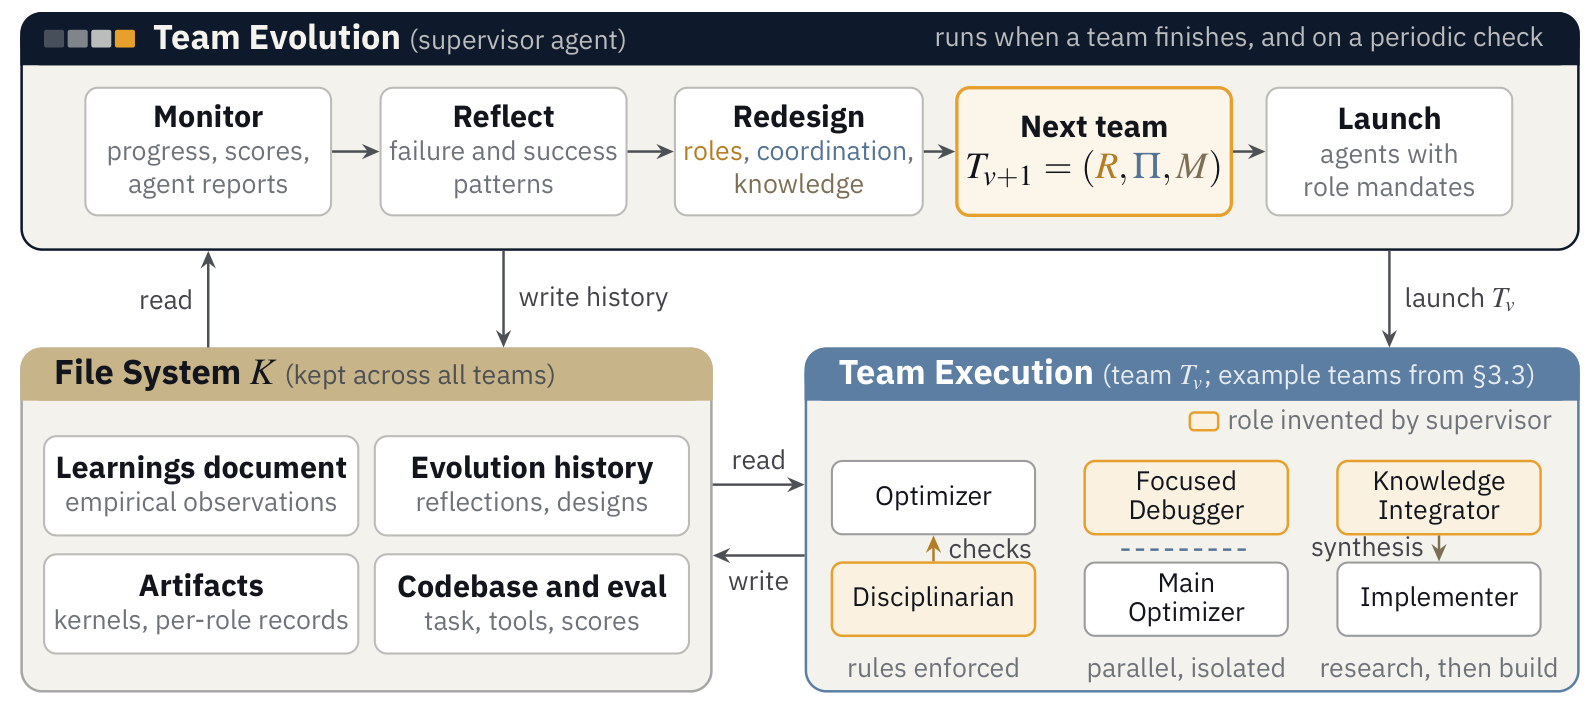
这篇把"要优化的东西"从解本身扩展到"搜索解的组织"——在长时间 GPU kernel 优化里,单 agent 和固定多 agent 团队都会滑向"容易实现但架构上限低"的方向并卡在局部最优;作者让一个 supervisor agent 在每次平台期诊断"卡在哪",然后重新设计下一支团队的组成、协作方式和知识管理,把经验写进跨团队持久的文件系统,从而在相同…
本文是一篇面向工程实践的架构思路探讨,并非对 DeepSeek Harness 现有产品功能的介绍。
Super-agent 设计探索:迈向更自主的 Agent 系统
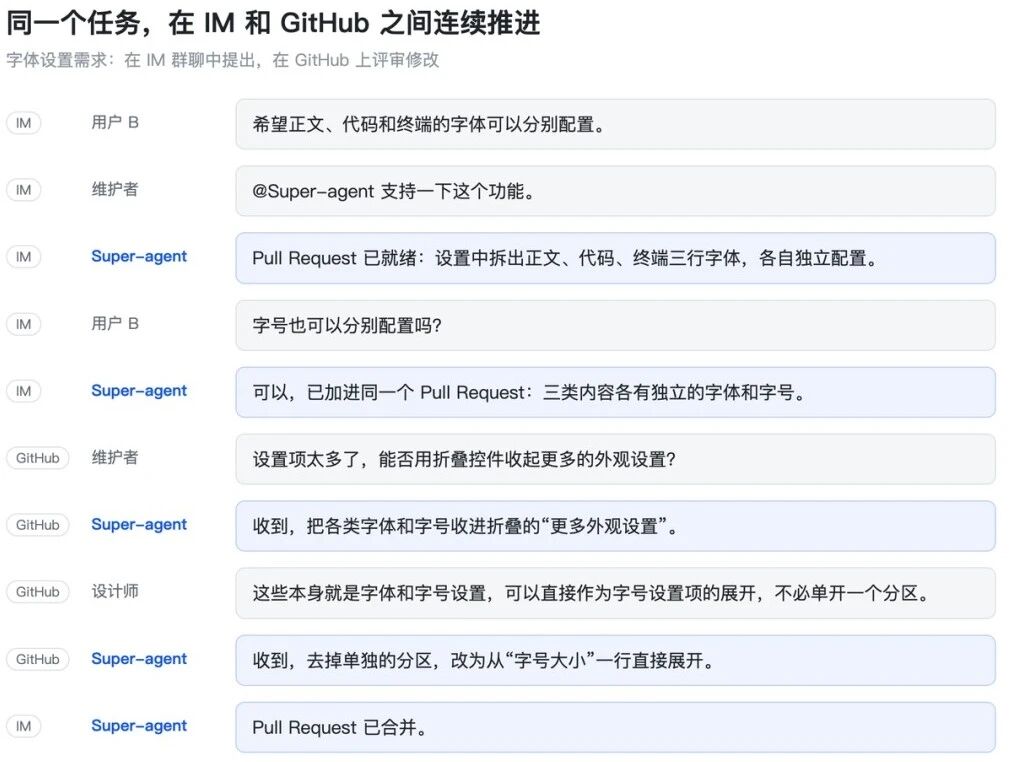
限制 Agent 继续扩张的瓶颈,已经从模型能力转移到人的注意力——一个人只能同时跟进 3 到 5 个活跃 Session,而主流 Agent 把「一个 Session」当成了工作单位。 解法是把 Session 降级为系统实现细节,在上面加一层常驻的 Router 和一个上下文隔离的 Worker 池。
Harness^2: Recursive Agent Harnessing for an Open World
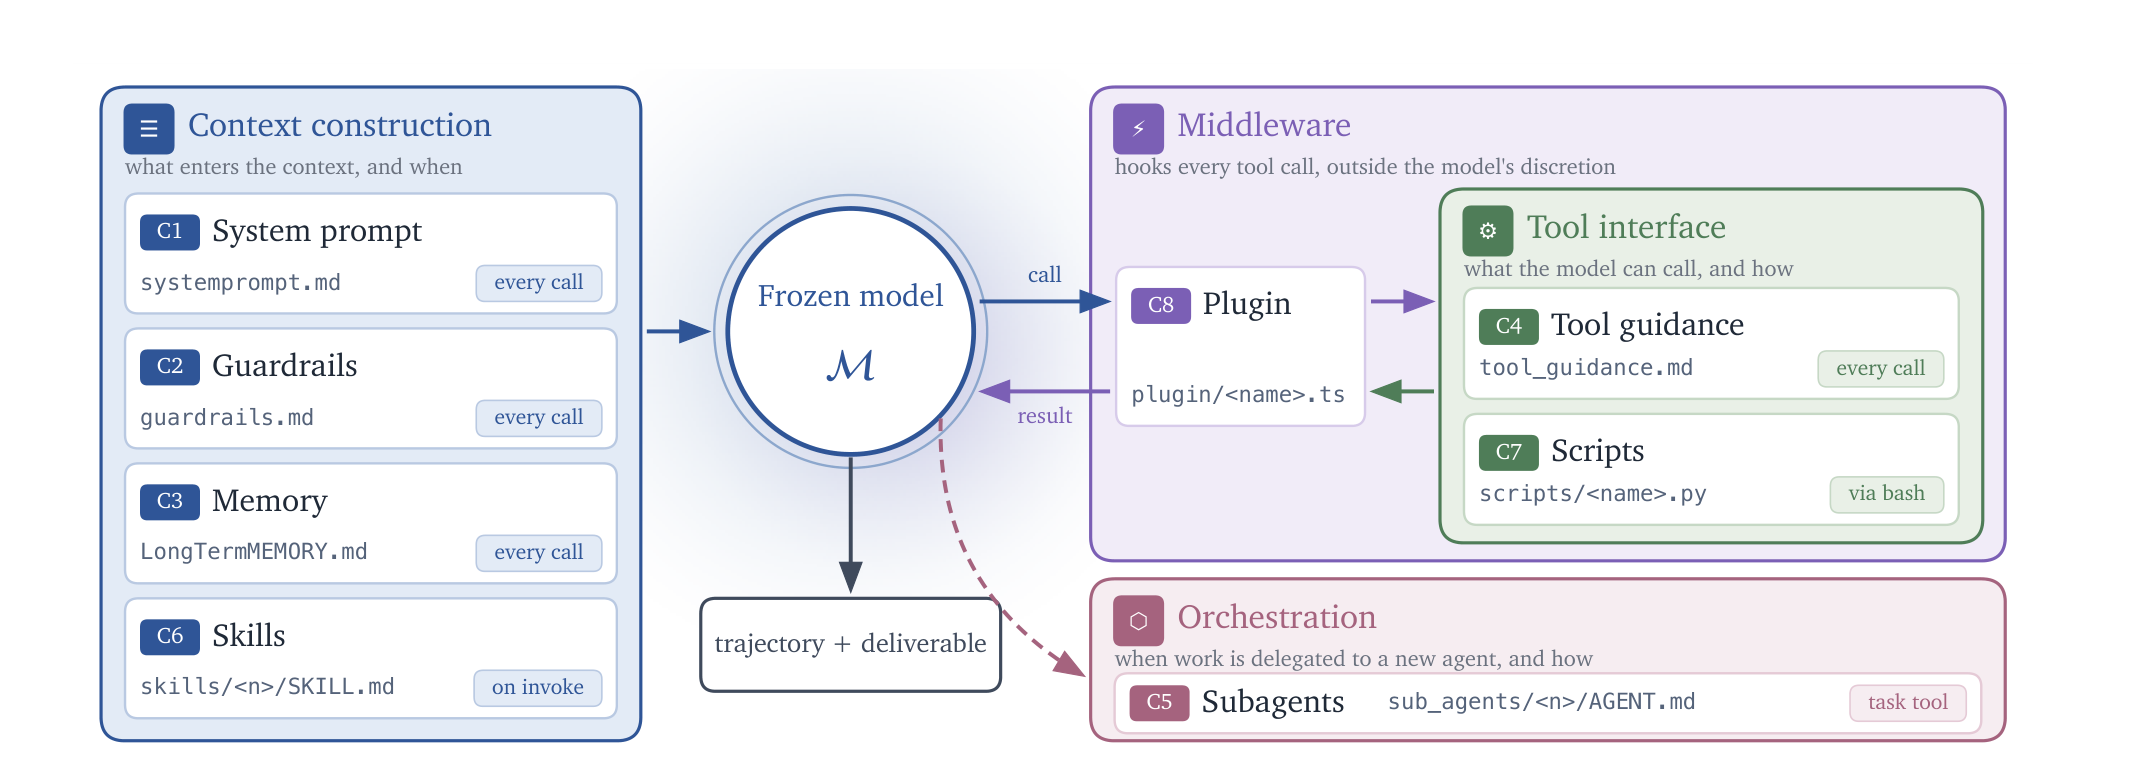
这篇把 RSI 的对象从「当前这个任务的 harness」扩成「改进 harness 的机制」——任务内用「提议–试探–合成」(Propose–Probe–Compose)在没有标准答案的条件下改执行 harness,任务后用这次改动的过程记录去更新一个「改进 harness」(实际上是一个装满了可用 harness 与经验的库),让下一次改进更有的放矢。
Building agents: When to fold subagents into your main agent loop
作者主张把"路由器 + 领域 subagent"的设计折叠成一个模型、一个上下文窗口、一个开放式工具循环,用"渐进披露的 skills 和 tools"替代"多开上下文窗口",理由是当代模型已经能在一个循环里承担原先需要拆出去的工作,而每一次跨 agent 交接都在丢信息、加延迟。
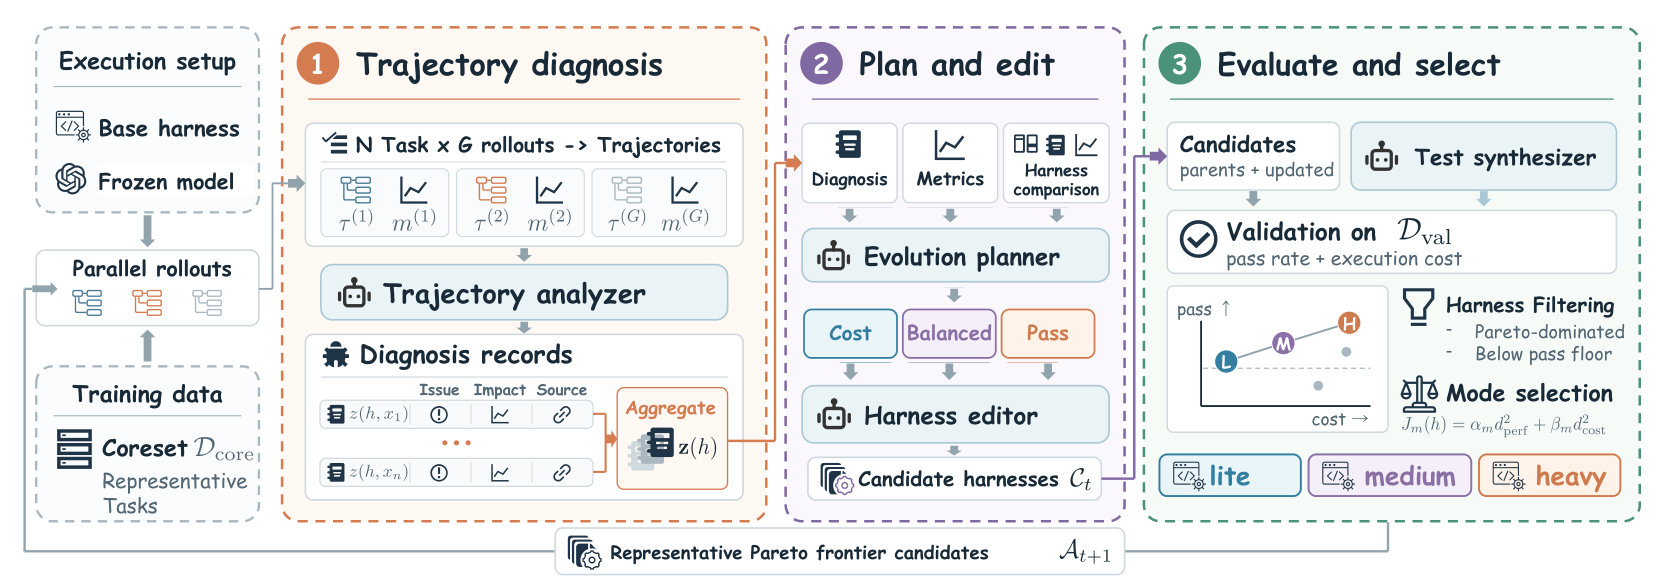
HarnessPro 把 harness 的递归自改进从「只追 pass rate」改成「pass rate + 每任务执行成本」的双目标搜索——它用固定的 LLM 生成测试替代 LLM 直接打分(label-free),让同一 planner 按省成本 / 平衡 / 保性能三种偏好各出一份计划,再由 harness editor 实现成候选,用 Pare…
HarnessX: A Composable, Adaptive, and Evolvable Agent Harness Foundry
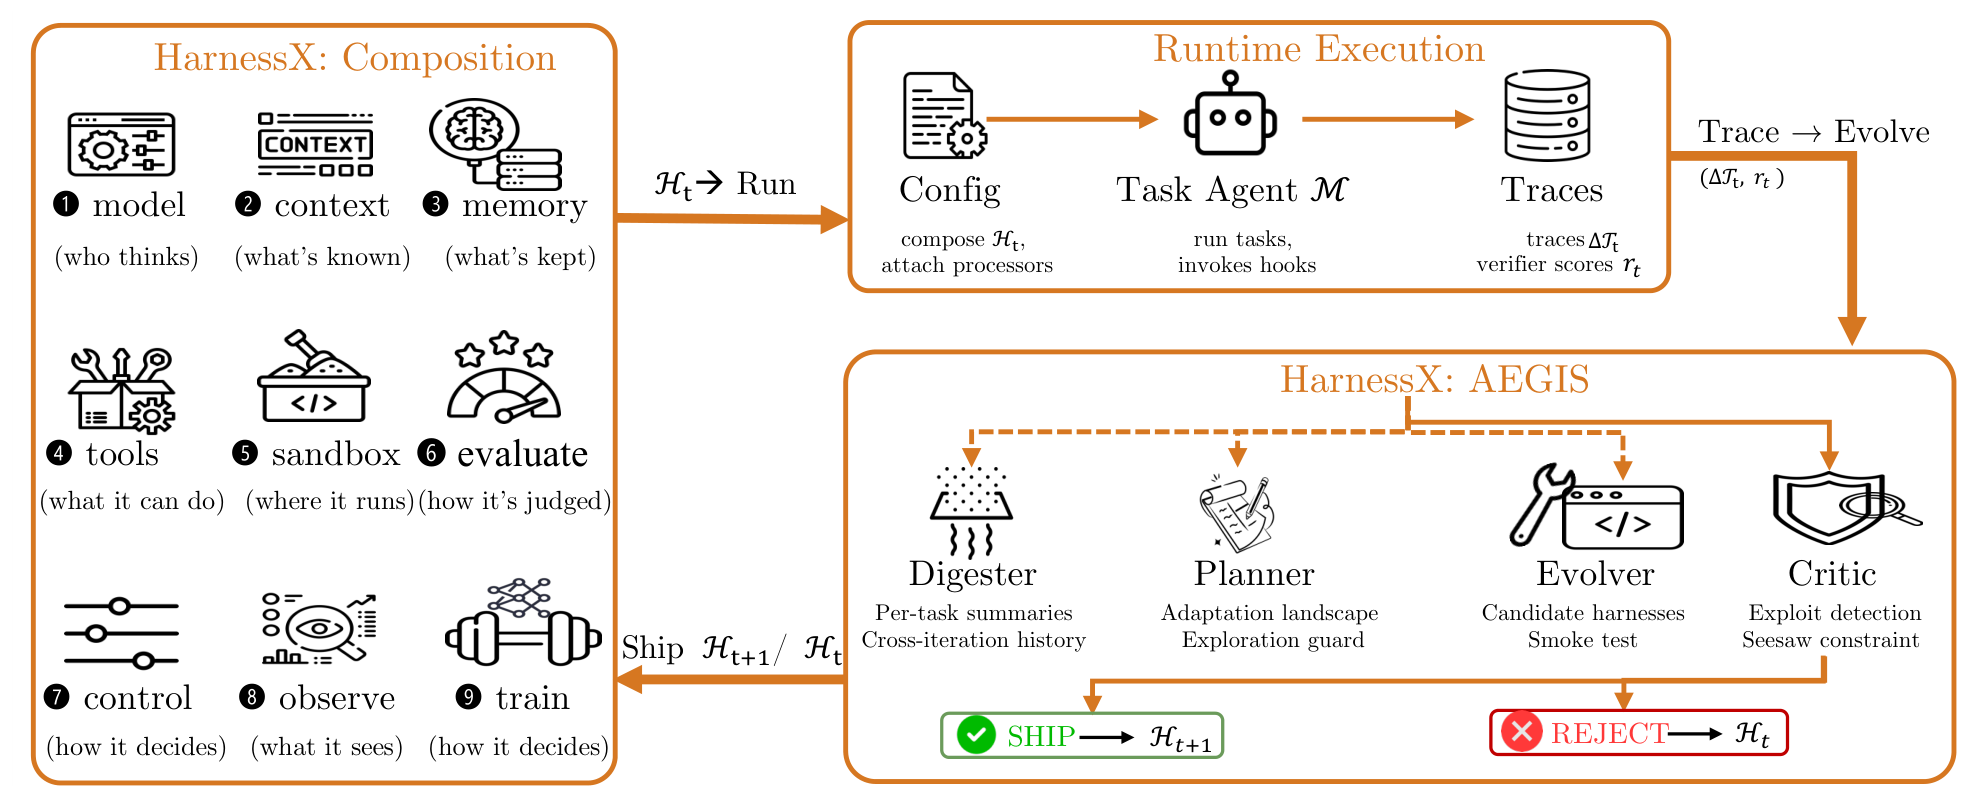
HarnessX 把 harness 本身做成一等公民:用类型化 processor 挂在 8 个生命周期 hook 上做组合,用「RL 镜像」把 harness 演化当符号空间的 MDP 来防守三类 RL 病理,再用一个共享 replay buffer 让 harness 演化与模型 GRPO 训练共演化——五基准 15 格平均 +14.5%(峰值口径)…
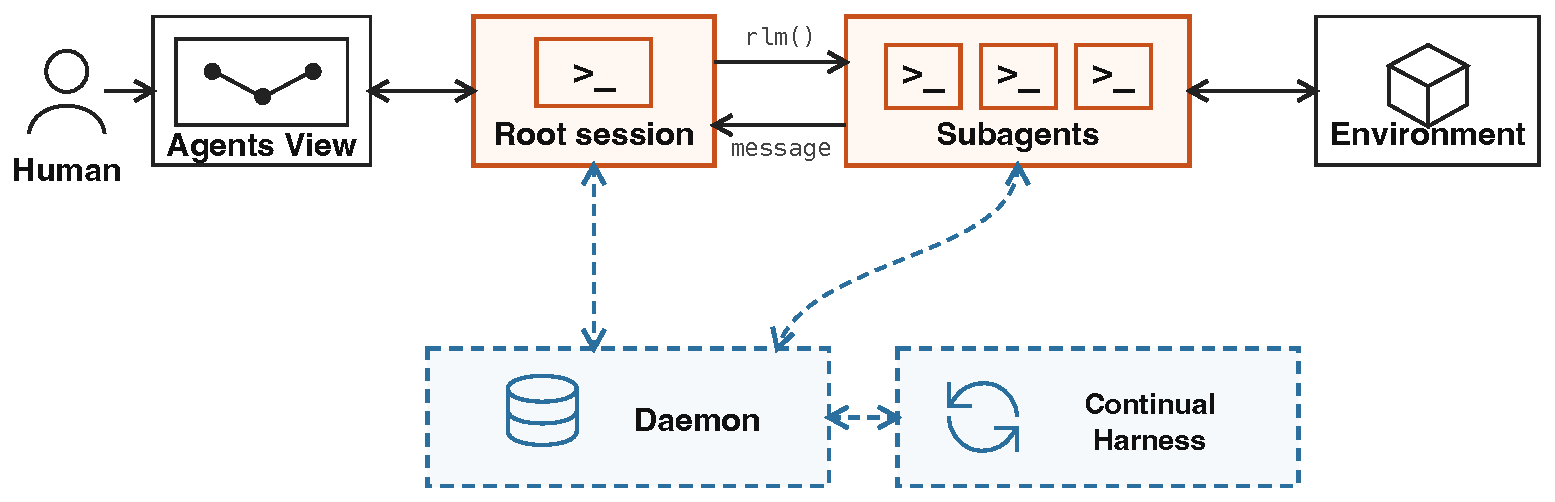
这篇论文不提出新模型或新训练方法,它交付的是一个 harness——以及一套把「harness 能力」当作可测量对象的方法。 它的核心主张是:长时程任务的评测里,harness 是模型观察和作用于世界的「膜」(membrane),模型应当因任务超出能力而失败,而不是因为 harness 丢状态、限制动作、算错资源或提前终止(§1 原话);因此好 harne…
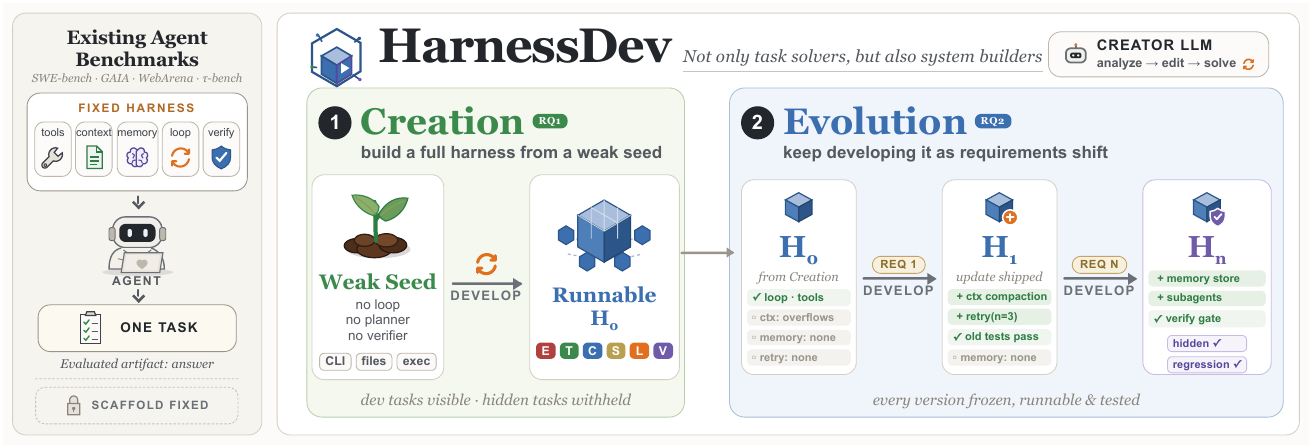
这篇把评测对象从「模型在给定 harness 里答题的成绩」换成「模型能否从零造出并且持续改进 harness 这个可运行系统本身」——结论是:2026-09 的前沿模型能从弱种子造出跑得起来的 harness,但在 code 与 search 上仍大幅落后人类工程版;演化(Evolution)阶段能在可见反馈集上涨分,涨分却不稳定,且向留出任务、向「换一…
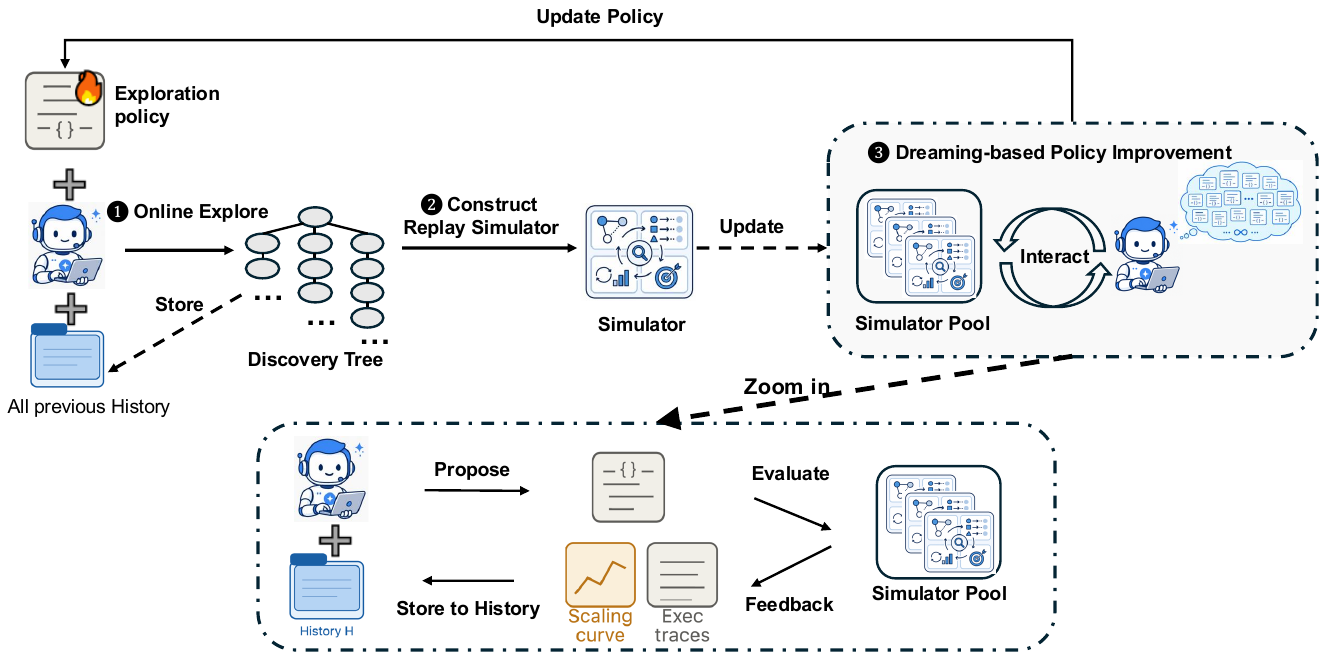
这篇论文把"自我改进"从"改模型/改候选"挪到了"改怎么搜"这一层——并且发现,只要把一次真实的、代价高昂的发现过程完整记录下来(决策树 + 每个节点的执行结果),这棵历史树本身就是一个零成本的世界模型(replay simulator),可以让大量候选探索策略在"做梦"中先比一遍,再把赢家部署回线上。
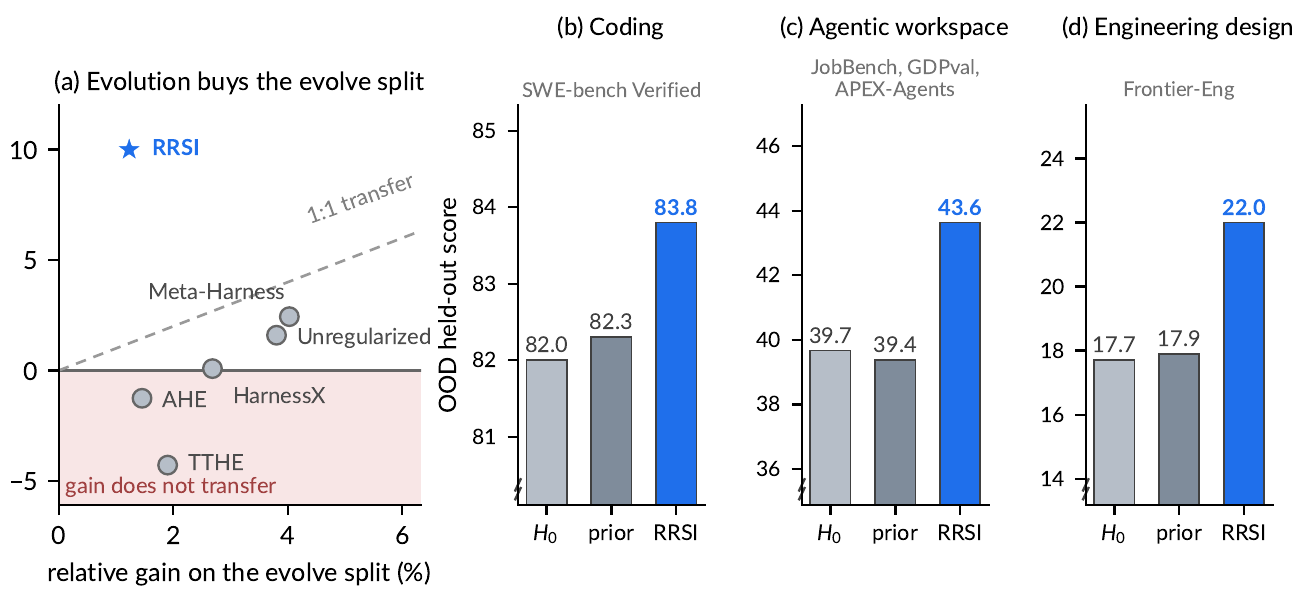
这篇论文把"用 agent 自己跑出来的反馈反复改 harness"这套 RSI 循环的失败模式诊断清楚了——不是搜得不够,而是搜的东西(有限 evolve set 被反复自适应复用)会过拟合——然后用四项来自经典正则化的约束去限制搜索轨迹(而非限制编辑空间),在 8 个 benchmark / 3 个领域上换来"evolve 集涨得最少、但留出集涨得最多…
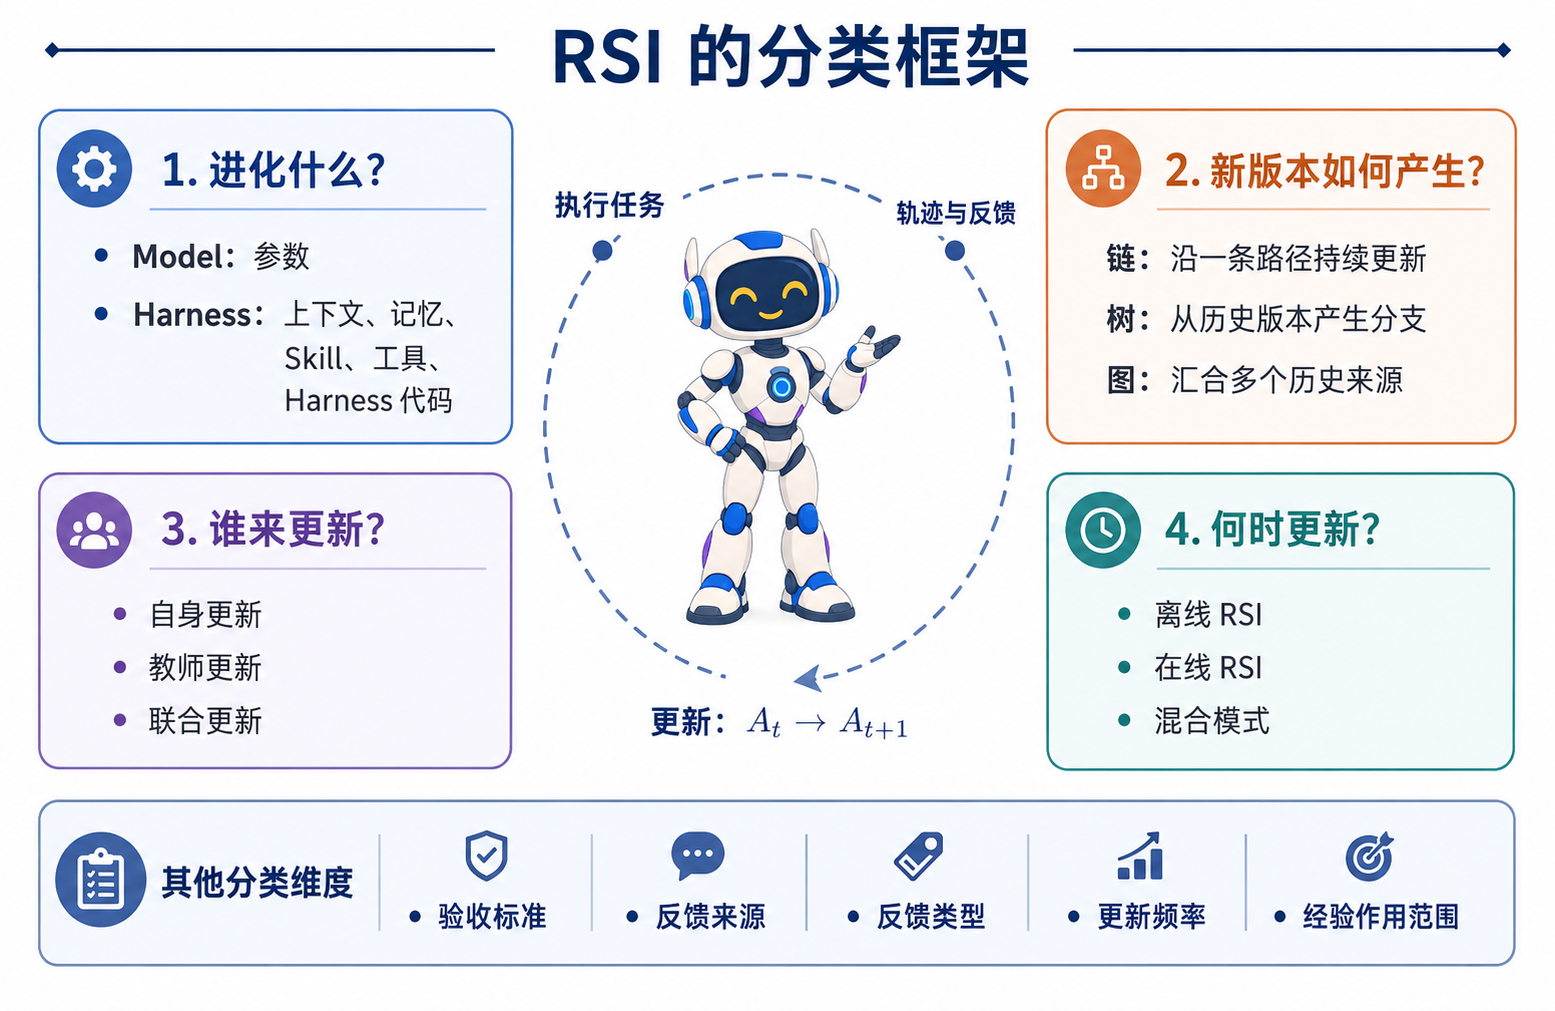
这不是一篇提出新方法的工作,而是一篇给"RSI / 自进化"建立坐标系的导读——它先把 RSI 收成一个闭环(下一轮 Agent A{t+1} 由本轮 Agent A_t、轨迹 τ_t、反馈 f_t 经更新算子 U 得到),再用四组主维度(进化什么 / 新版本如何产生 / 谁来更新 / 何时更新)加五组次级维度(验收标准 / 反馈来源 / 反馈类型 / 更…
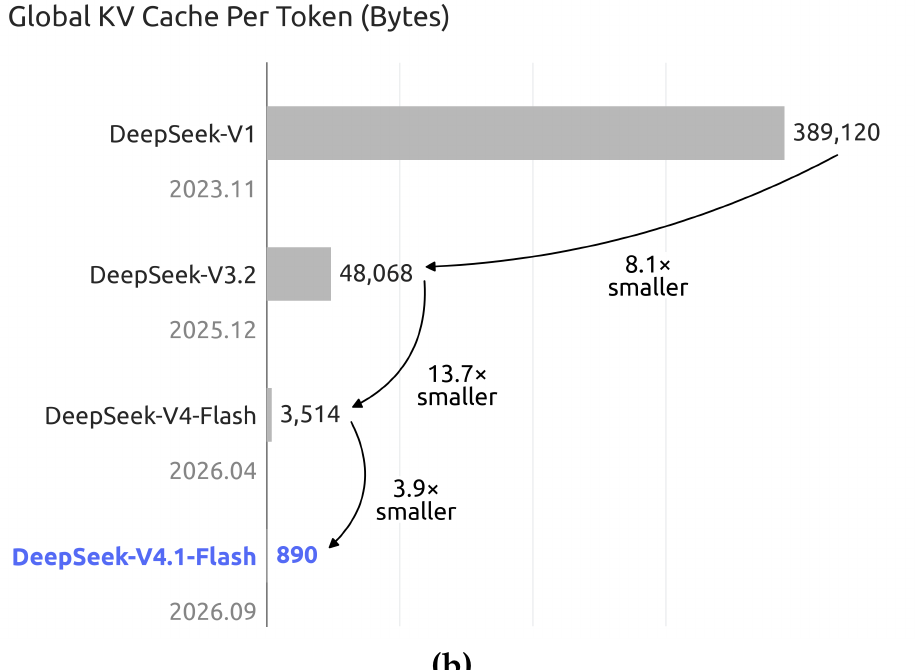
这篇报告的主题不是「模型更强」,而是把长上下文推理的成本从「算」转移到「省」——用 CED 砍掉近一半 prefill 计算,用 CSA2 的跨层 KV/索引复用把 decoder 的 KV 生产层压到 1 层,再用 FP4 主 KV 缓存把每个字节再砍一半;部署侧用近似的 SWA Bounded Replay 换掉 SSD 上的 SWA 持久缓存。代价是…
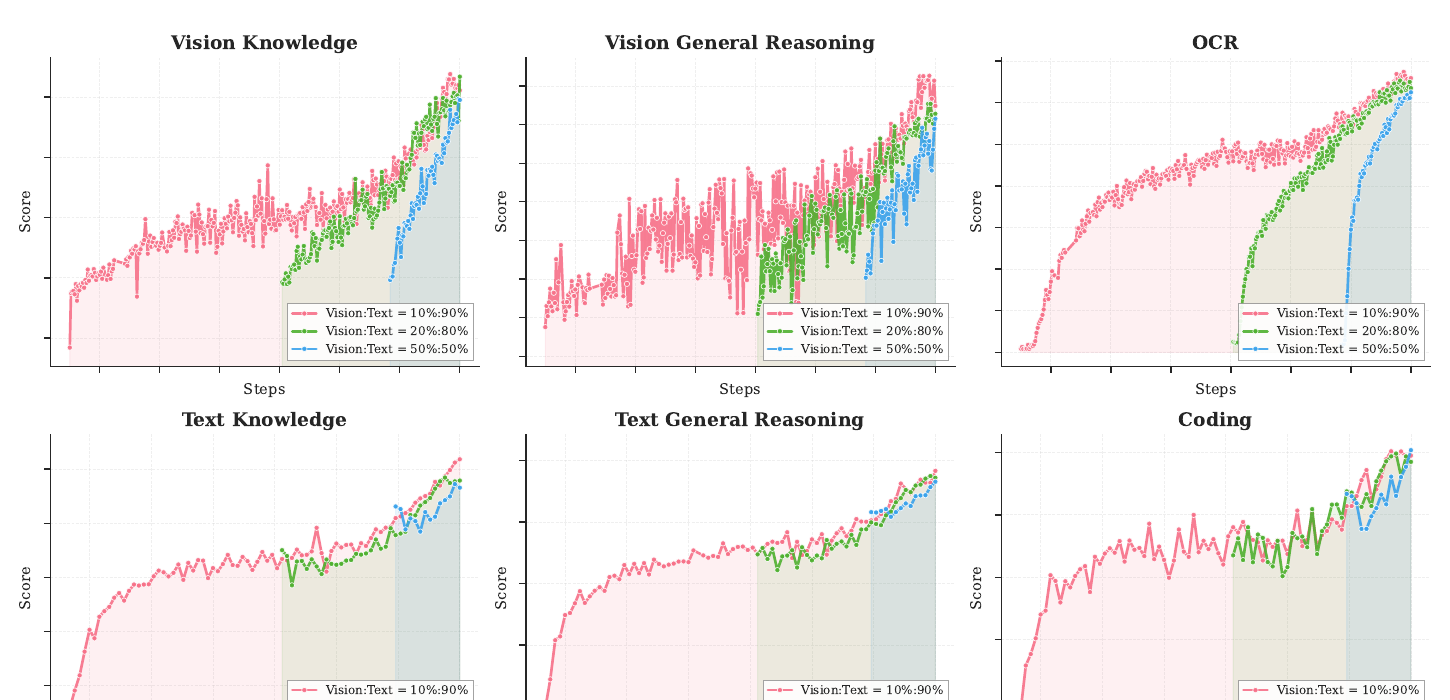
K2.5 = Kimi K2(1T MoE 语言底座)+ 原生多模态(MoonViT-3D 视觉编码器,约 15T 图文混合 token 联合预训练)+ Agent Swarm(用 PARL 训练并行多智能体编排)。论文的两个主张是「文本与视觉联合优化让两个模态互相增强」和「并行 agent 编排把任务复杂度从线性串行变为并行处理」。
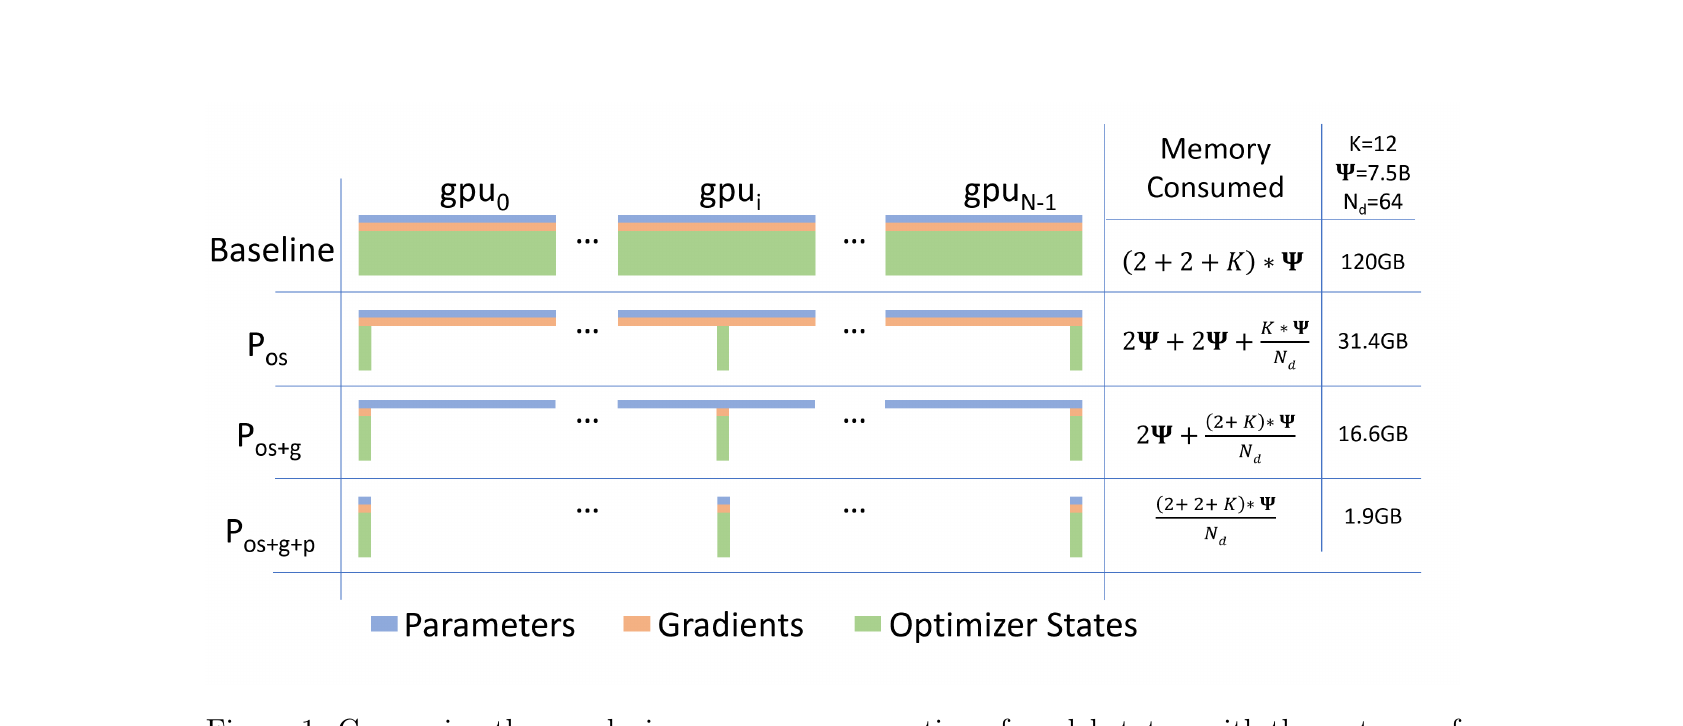
ZeRO 在数据并行(DP)框架内把「模型状态」从每卡复制一份改为按 DP 度数切分、用时再通信聚合,从而在不牺牲计算/通信效率的前提下拿到接近模型并行(MP)的内存效率。
没有匹配的笔记
换一个关键词,或清除筛选后再试。